一文看懂 KV Cache
一文看懂 KV Cache
创作者简介—[@杨汶锦][@王凯]
Hi,大家好👏,本文作者长期专注于大模型推理系统研发与落地,主要在昆仑芯 P800 / P900 系列芯片上从事推理加速与优化、推理系统建设及超节点方向工作,在推理引擎优化、PD 分离、超节点模型适配与端到端性能调优方面具备扎实的一线实践经验。
🏷️ 技能标签:大模型推理 | 推理系统 | KV Cache 加速 | SGLang | PD 分离 | 超节点
写在前面,本篇文章主旨就是回答以下几个问题:
- KV Cache 如何提升推理性能 ?
- sglang 和 vllm中KV Cache 如何进行管理 ?
- 目前业界主流的 KV Cache 优化方向有哪些 ?
如果你对这三个问题都知道答案,那么本篇文章可以不用阅读
1.KV Cache 介绍
随着输入给 LLM 的 token 列表增长,Transformer 自注意力阶段可能成为性能瓶颈。token列表越长,意味着相乘的矩阵越大。每次矩阵乘法都由许多较小的数值运算组成,这些运算称为浮点运算,其性能受限于GPU的每秒浮点运算能力(FLOPS)。这样,在LLM的部署过程中,推理延迟和吞吐量问题成为了亟待解决的难题。这些问题主要源于:
- 生成推理的序列自回归特性,需要为所有先前的标记重新计算键和值向量。
- 由于注意力机制与输入序列的大小呈二次方关系增长,因此在推理过程中,注意力机制往往会产生最大的延迟开销。
为解决推理延迟和吞吐量问题,最常用的优化技术是 KV Cache。KV Cache 是一种关键的性能优化机制。它通过缓存已计算的Key和Value矩阵,避免在自回归生成过程中重复计算,从而显著提升推理效率(本质就是用空间换时间)。这种机制类似于人类思维中的短期记忆系统,使模型能够高效地利用历史信息。
冗余计算
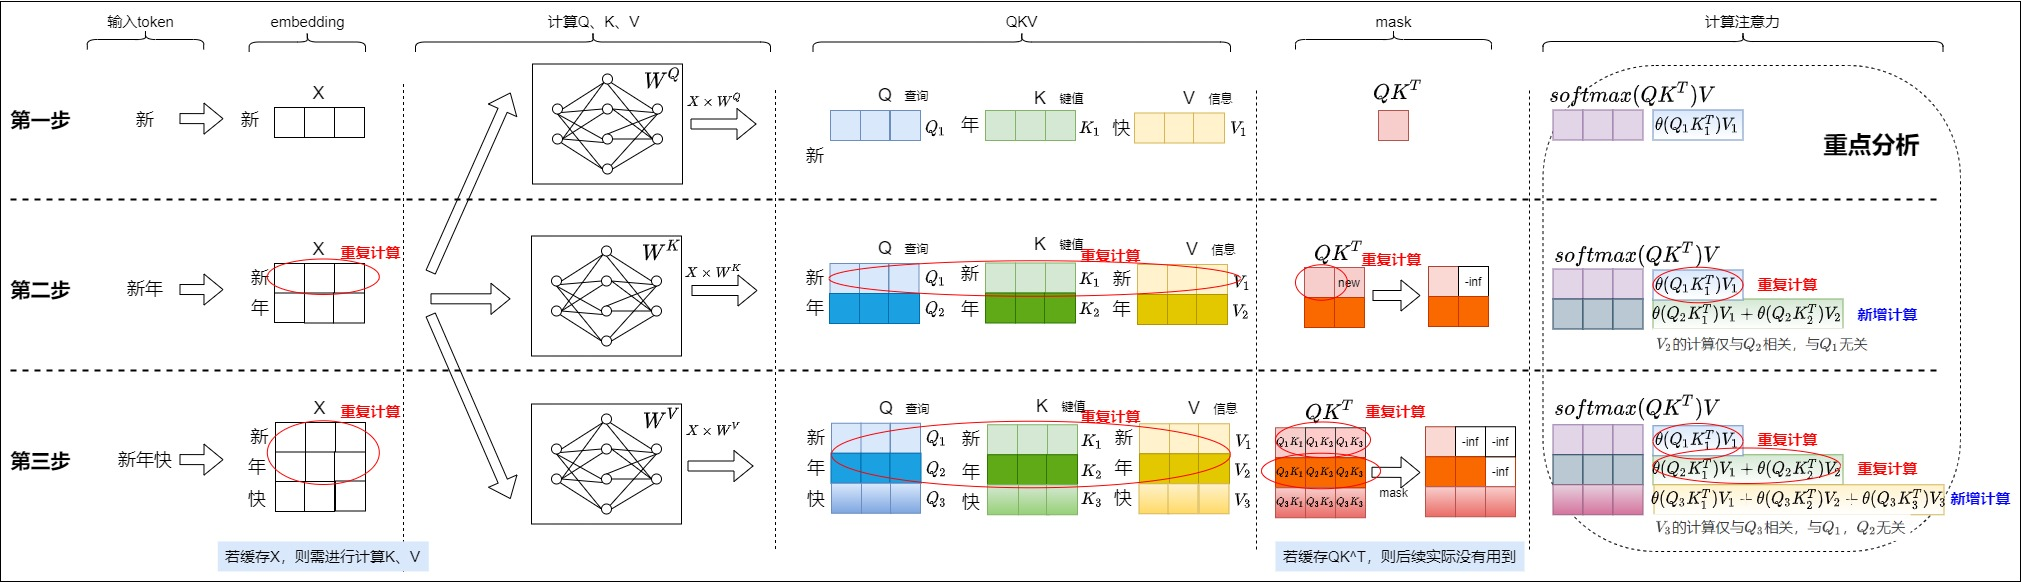
左边图中会发现其中存在大量的冗余计算,每生成一个token需重新计算所有历史token的Key/Value,复杂度为 O(n2) ,显存和计算时间随序列长度急剧增长,如下所示:
- 生成embedding有冗余计算。
- KV生成有冗余计算。
- QKT有冗余计算。
- softmax操作以及与V相乘有冗余计算。
理论基础
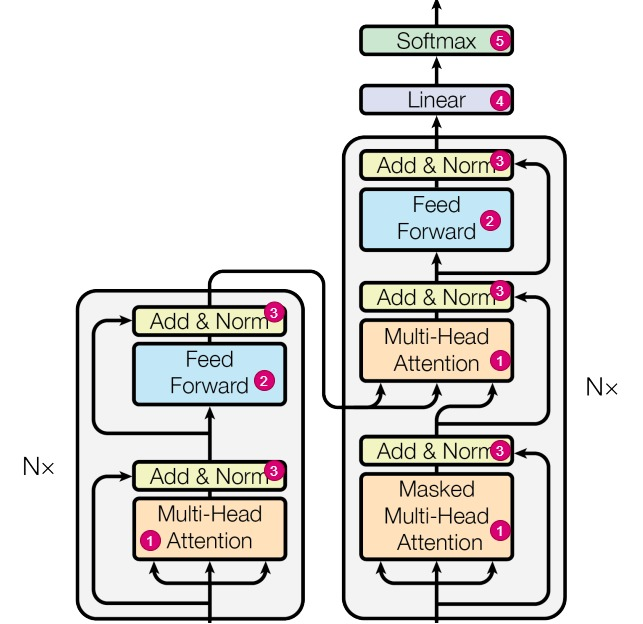
注意力模块(对应上图中标号1)。
- 推理时,前面生成的token看不到后续生成的token,所以前面已经生成的 token不需要与后面的 token进行注意力计算。在“单向 attention”的影响下,序列预测过程的第 i 个时间步的 query 向量 qi 不会影响前序所有时间步的 [k1,k2,…,ki−1] 和[v1,v2,…,vi−1] 。比如, i=3 时的 k2 和 i=4 时的k2 完全相同。在 Transformer 的每一层,Key 和 Value 都不会被重复计算。
- 训练时,由于掩码技术的使用,在生成当前 tokens 的输出表征时,仅使用之前已生成 tokens 的信息,而不使用之后生成的 tokens 的信息。即Qi与Ki+j,Vi+j的计算会被mask掉,不需要计算。掩码的主要优点是将(自)注意力机制的FLOPs需求从与总序列长度呈二次方扩展变为线性扩展。在每个生成步骤中,我们实际上可以避免重新计算过去token的键和值,而只需计算最后生成的token。每次计算新的键和值时,我们的确可以将它们缓存到GPU内存中以供未来重复使用,因此节省了重新计算它们时所需的浮点运算次数。
FFN(对应上图中标号2)。在FFN计算中,序列中各个词对应的特征不会交互信息,不会互相影响,并且最终只取最后一个位置的输出特征作为下一个token的概率分布。因此,经过FFN层后,第 i 个输出的新增计算只和第 i 个输入有关,和其他输入无关,比如下面Y1的计算只和X1相关。
- Add & Norm(对应下图中标号3)。对于LayerNorm,它是在
d_model方向上计算均值和方差,然后进行归一化,因此它的输出也只与输入hidden_state的最后一行相关。 - Linear(对应下图中标号4)。这是一个将
hidden_state的维度从d_model变换到vocab_size的线性映射,根据矩阵乘法的性质,可以知道logits的最后一行只与hidden_state的最后一行相关。 - Softmax(对应下图中标号5)。softmax只要把之前的计算结果存储起来,就可以结合新计算的结果来进行计算。
- Add & Norm(对应下图中标号3)。对于LayerNorm,它是在
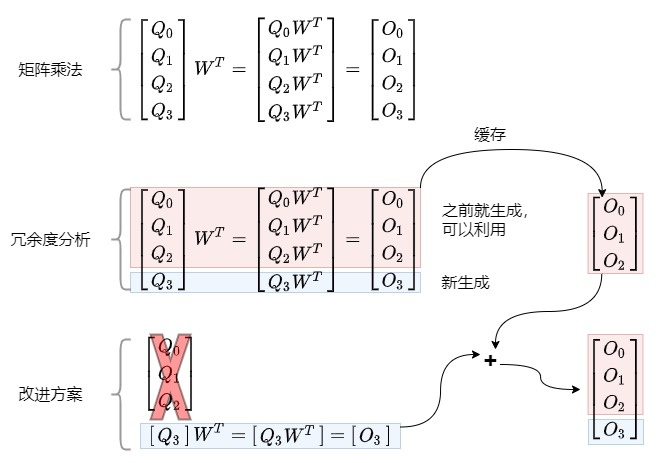
假设矩阵A和矩阵B相乘,我们将矩阵A拆分为[:s], [s]两部分,分别和矩阵B相乘,那么最终结果可以直接拼接,该结果与不分拆结果一致。注意力和FFN都是矩阵乘法操作,因此将[:s]部分缓存,来避免[:]整体输入导致的重复计算。
** KV Cache 自回归流程**
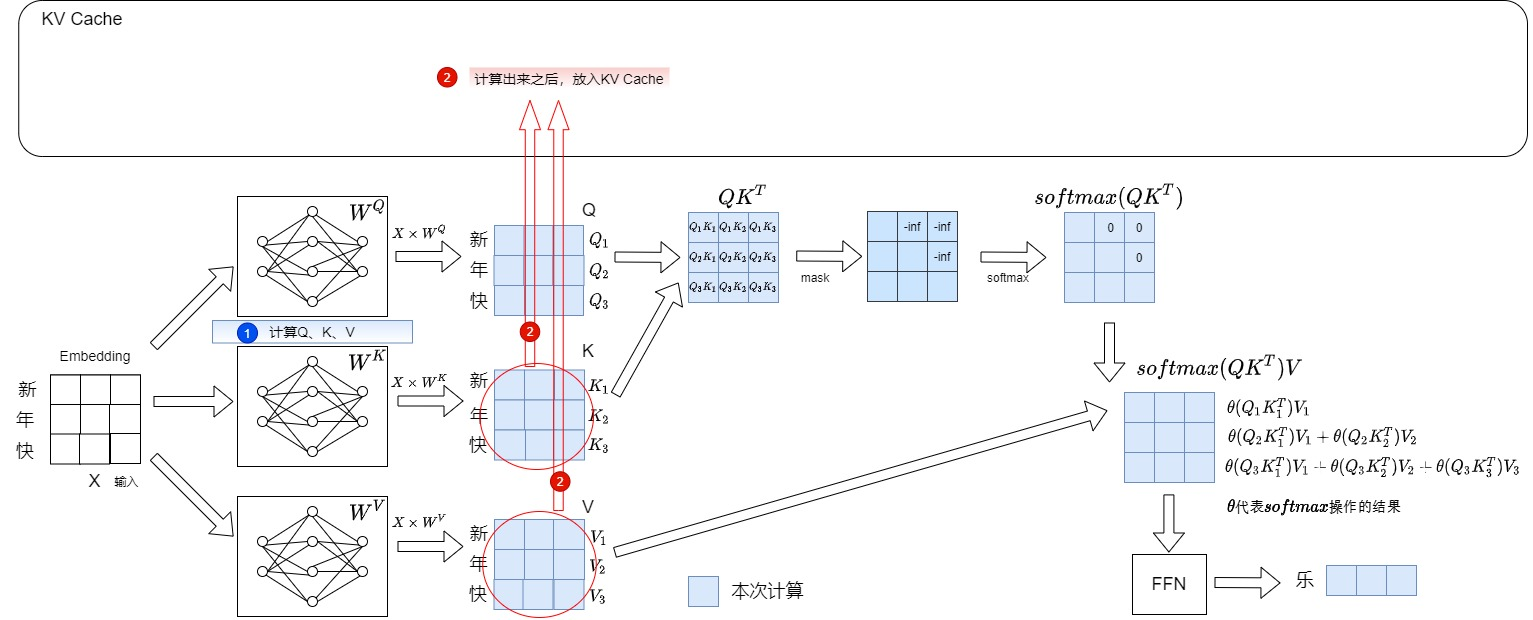
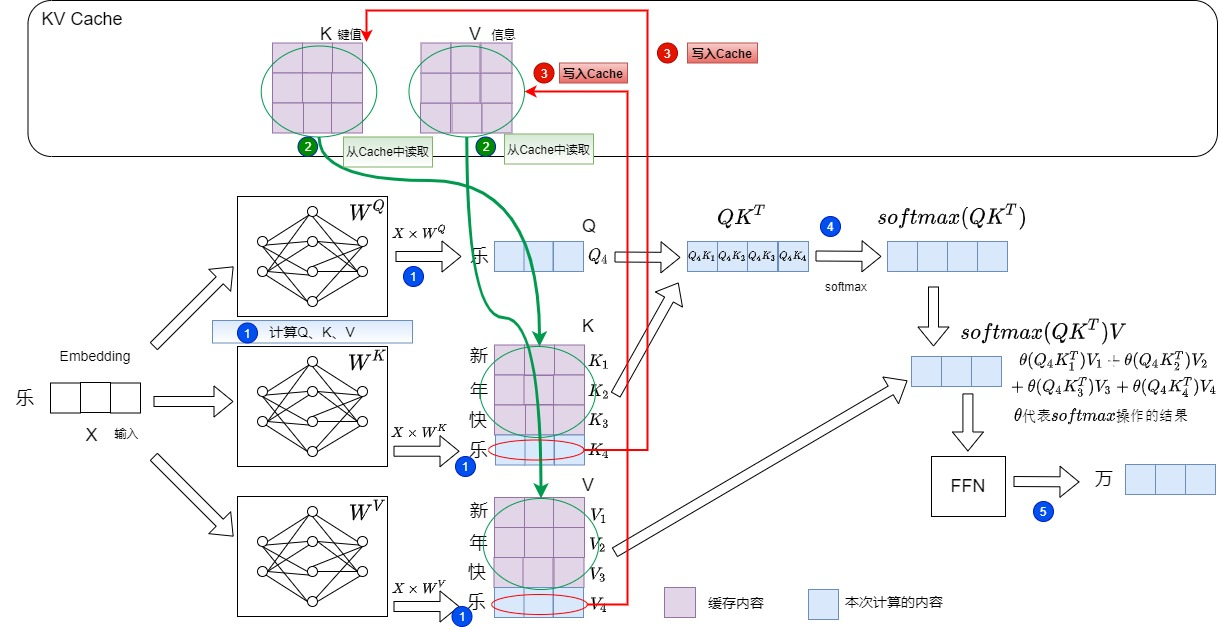
我们输入的prompt为"新年快“,期望输出“乐”。
- 计算"新年快" 对应的Q、K、V值,对应左图1。
- 此时会把“新年快”这三个词的KV存储在KV Cache中。对应左图2。
- 后续经过softmax和FFN计算,输出"乐"。
下一步输入“乐”,希望输出“万”。具体操作如下:
- 计算“乐”对应的Q,K,V值。对应左图的标号1。
- 从KV Cache中提取“新年快”这三个token对应的 K 和 V。拼接历史 K、V 的值,得到完整的 K、V,即Key-Value Cache 机制将前序所有时间步的 Key 和 Value 缓存起来。对应左图的标号2。
- 把”乐“对应的K和V存储到 KV Cache中。对应左图的标号3。
- 计算注意力,对应左图的标号4。此时注意力机制的输入变为最后生成的tokenqi(而不是整个序列)和KV缓存与最后token(ki,vi)的拼接。
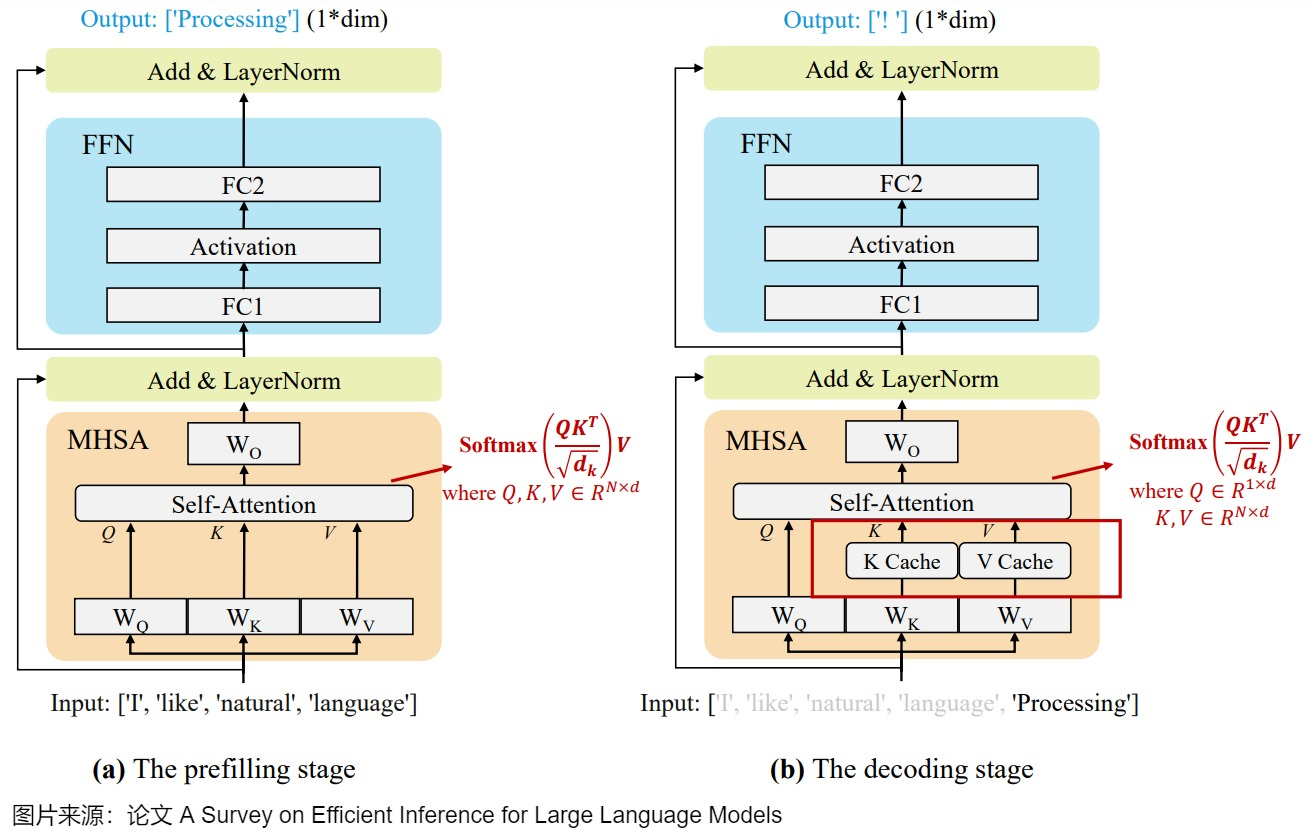
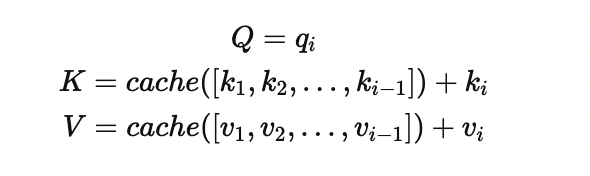 结合模型结构来阐释这两个阶段如何使用KV Cache:
- prefill 是将1个请求的Prompt一次性转换为KV Cache,并生成第1个Token的过程。仅对最后一个Logit进行解码得到第1个生成的Token;中间过程计算得到的K、V将被保留在显存中。
- decode 是后续新生成token的阶段,此时会利用prefill的cache以及阶段本身产生的cache进行结算,中间过程计算得到的K、V追加到KV Cache中。
KV Cache计算公式
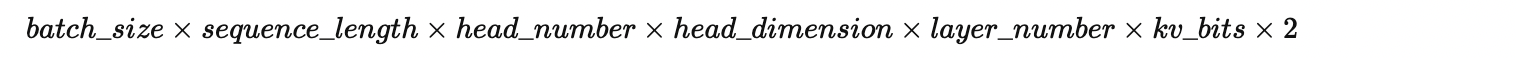
实际案例:
假定100K上下文,60层,8的头,128的嵌入维度,使用bf16存储,则KV Cache大小为:
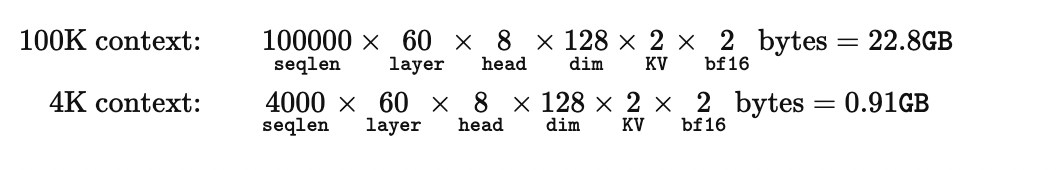
以 Qwen3-32B 为例,模型参数以 BF16 格式加载时约占用 64 GB 显存。模型共有 64 层,采用GQA实际 KV 维度为 1024。当 batch size 为 4、序列长度为 32768,并使用 BF16 保存 KV Cache 时,其占用空间为:
2(K & V)× 64(层数)× 4(batch size)× 32768(序列长度)× 1024(KV 维度)× 2 字节= 32 GiB
如果 batch size 增加到 8,KV Cache 将增长到约 64 GiB,接近模型参数本身的显存占用。由此可见,KV Cache 会随 batch size 和序列长度线性增长,在高并发和长上下文推理场景中,往往是限制服务并发能力的重要因素。
2.KV Cache 优化思路
推理性能指标
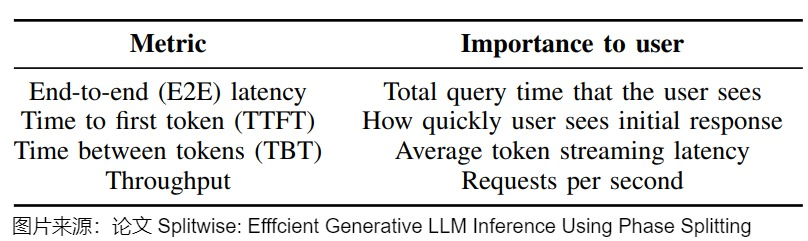
 推理加速一般可以从两个层面体现:吞吐量与延迟。
- 吞吐量:吞吐量 (Throughput) 是从系统的角度来看的指标,或者说是 LLM 服务的成本指标,表示每生成一个 token 服务商需要支付的算力成本。吞吐量有多种评估方式,比如 tokens per second(tps),即推理服务器单位时间内能处理针对所有用户和请求生成的输出token数。如果不仅考虑预填和解码,还考虑内存限制和上下文切换,则可以考虑基于会话的吞吐量,即在给定时间内的并发用户交互数量,是一个端到端的目标。
- 延迟:模型为用户生成完整响应所需的总时间可以使用这两个指标来计算:TTFT和TPOT。首Token生成时间(Time to First Token,简称TTFT),单个输出词元的生成时间(Time Per Output Token,简称TPOT),token之间的时间(TBT)。
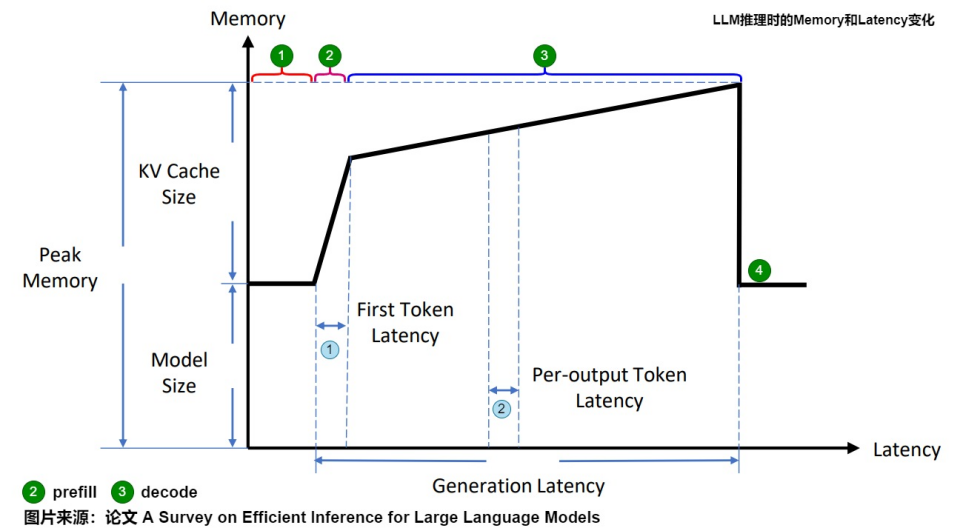
LLM的推理过程一般分为预填充(Prefill)和解码(Decode)两个阶段。预填充阶段负责处理输入提示(Prompt)的完整内容,计算量大但并行性高,同时生成第一个Token;解码阶段则通过自回归方式逐个生成后续的Token,尽管单步计算量较小,但每个新Token的生成都必须反复访问之前生成的所有Token对应的KV缓存(Key-Value Cache)。
左图则可以从细节来查看推理中KV cache对显存的占用,以及推理的不同阶段关注的指标。其中:
- Model memory:模型内存。模型大小保持不变,不受序列长度或批次大小的影响。
- Peak Memory:峰值内存 = 模型内存+kvcache。
- Latency:生成总耗时 = TTFT+TPOT*生成的token数目。
3.3.KV Cache 优化分类
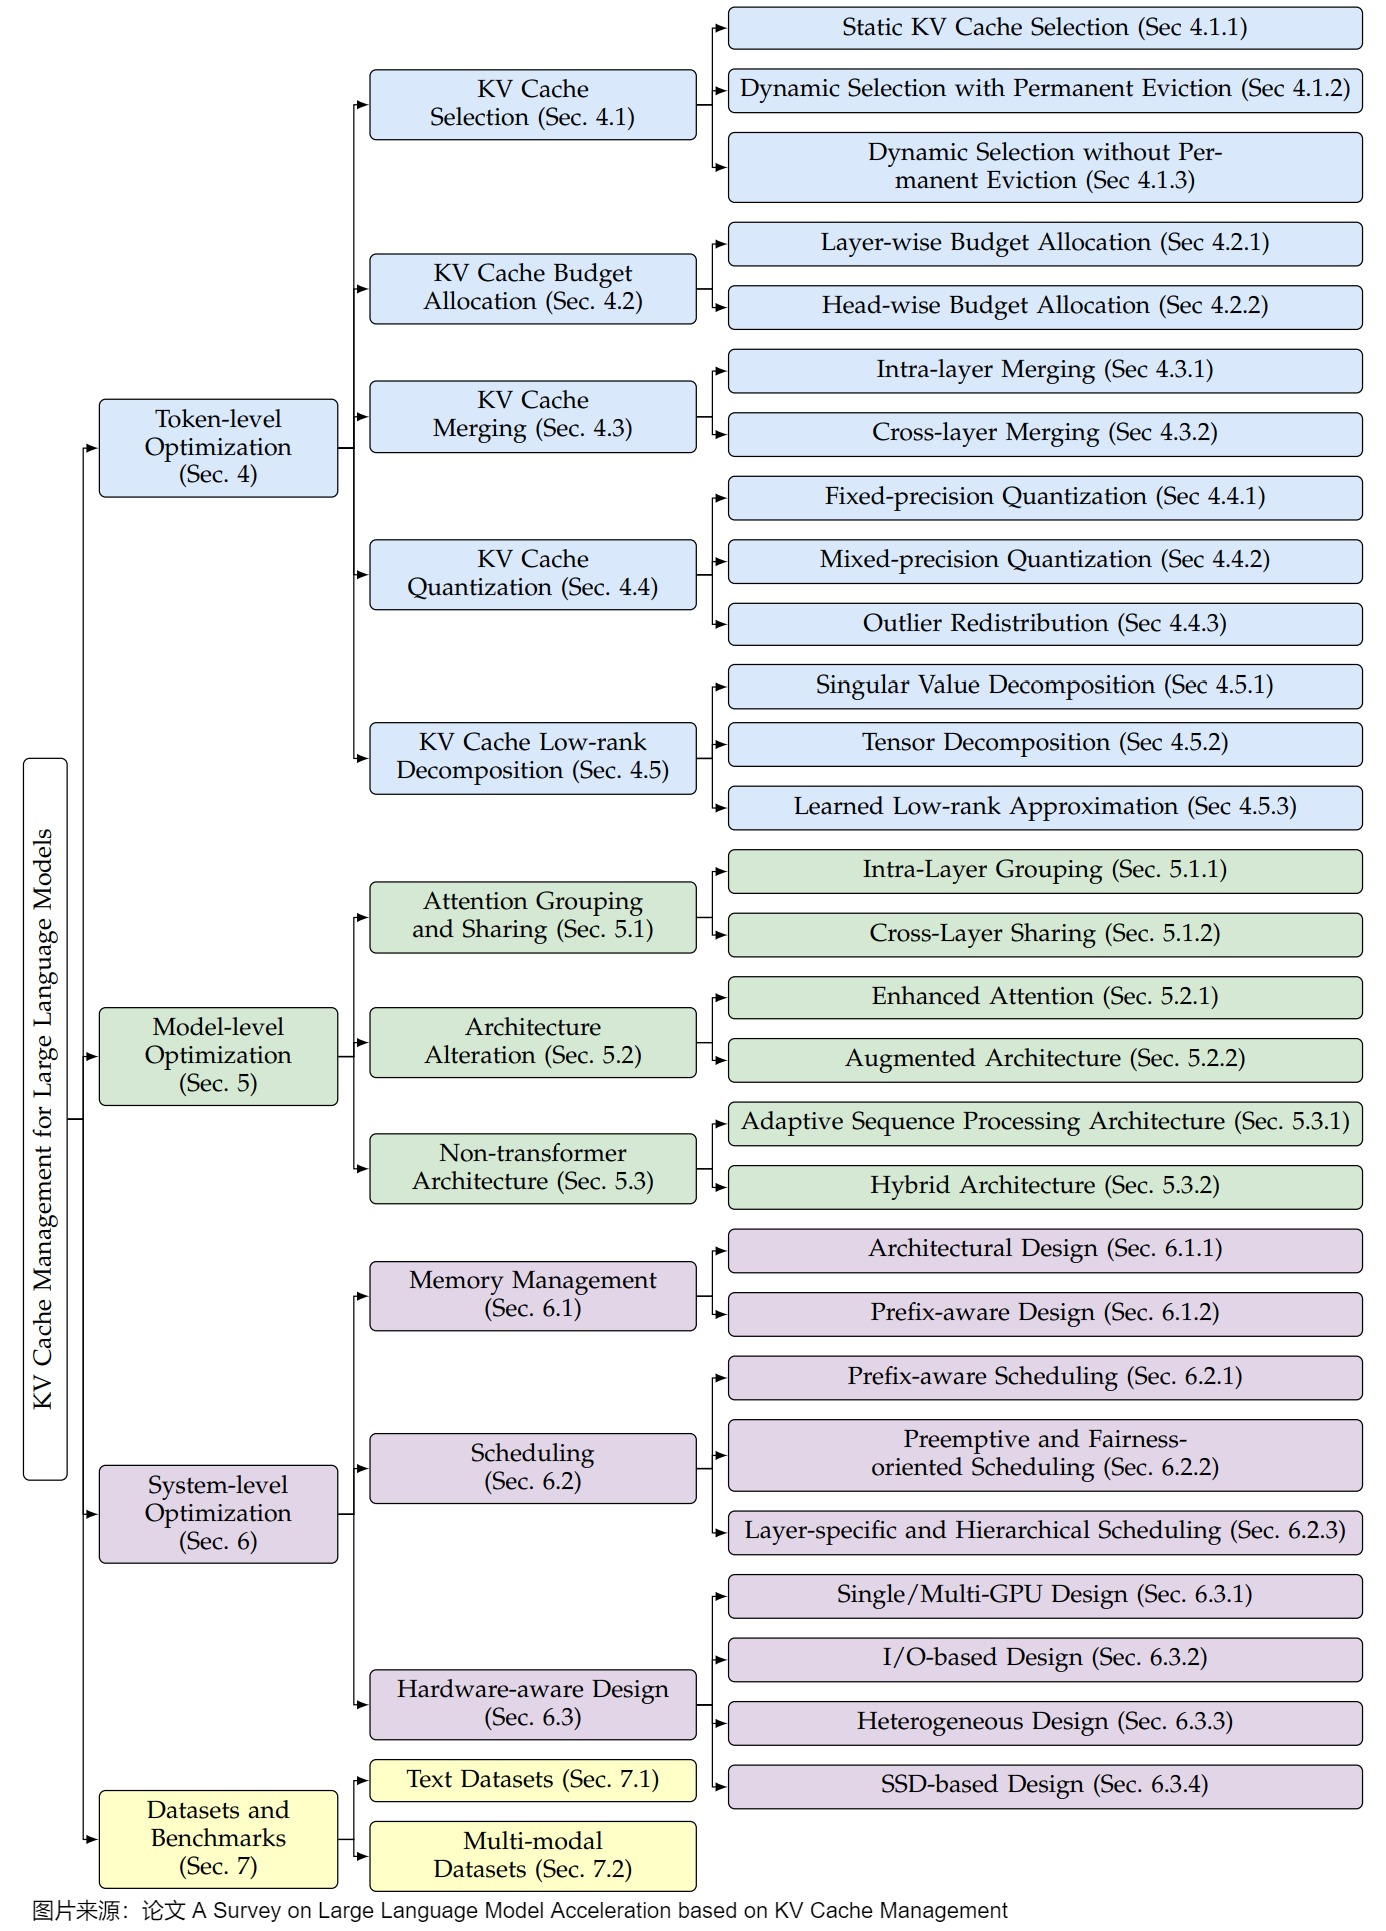 左图来自论文“A Survey on Large Language Model Acceleration based on KV Cache Management”。该论文基于KV Cache对LLM推理时间与内存需求的显著影响,系统梳理了现有优化策略,并将其划分为三个层次:token 级优化、模型级优化、系统级优化。
token级优化:是指通过专注于细粒度来提高KV缓存管理效率。在token级进行仔细的选择、组织和压缩,不需要对原始模型进行架构更改或系统并行技术。优化方法分为五类:KV Cache选择、预算分配、合并、量化及低秩分解。这些方法通过直接操作token级数据,实现了计算效率与内存需求的初步优化,为后续更高层次的改进奠定基础。
- KV Cache选择:侧重于优先排序和仅存储最相关的token。优先存储对推理最重要的token,通过评估token相关性减少冗余缓存,提升内存利用率。
- KV Cache预算分配:在token之间动态分配内存资源,以确保在有限内存约束下优化缓存分布,确保高效利用。
- KV Cache合并:识别并合并相似或重叠的KV对来减少冗余存储,进一步压缩缓存规模。
- KV Cache量化:通过降低KV对的存储精度(如从Float32到Float16或更低比特)来最小化内存占用,同时需平衡精度损失与性能收益。
- KV Cache低秩分解:利用低秩分解技术将KV矩阵分解为较小维度表示,压缩缓存体积,同时保留关键信息。
模型级优化:是指从架构设计角度优化KV Cache管理,通过调整模型结构或引入新机制减少缓存依赖,从根本上减少KV Cache的生成与使用需求,提升整体效率。具体策略包括:
- 注意力分组和共享:检查键值对的冗余功能,并在Transformer层内或跨Transformer层进行分组和共享KV缓存,降低存储需求。
- 架构更改:设计新的注意力机制或构建用于KV优化的外部模块,针对KV优化重新构造模型计算流程,减少对缓存的直接依赖。
- 非Transformer架构:这些架构采用了其他内存高效的设计,如使用循环神经网络来优化传统Transformer中的KV缓存。
系统级优化:是指从底层硬件与资源调度角度优化KV Cache管理,涉及内存分配与任务调度等经典问题,旨在最大化硬件资源利用率,以在多样化计算环境中提升效率。具体技术包括:
- 内存管理:通过架构创新优化内存使用,如虚拟内存适配、智能前缀共享和层感知资源分配,确保缓存高效存储与访问。
- 调度策略:通过前缀感知方法以最大限度地提高缓存重用率,采用抢占式技术实现公平上下文切换,或设计层特定机制进行精细化缓存控制,以解决多样化优化目标。
- 硬件感知设计:针对单/多GPU、I/O优化、异构计算及SSD存储提出解决方案,提升KV Cache的访问速度与存储容量。
公式化角度分析
KV cache 具体方向如下所示:
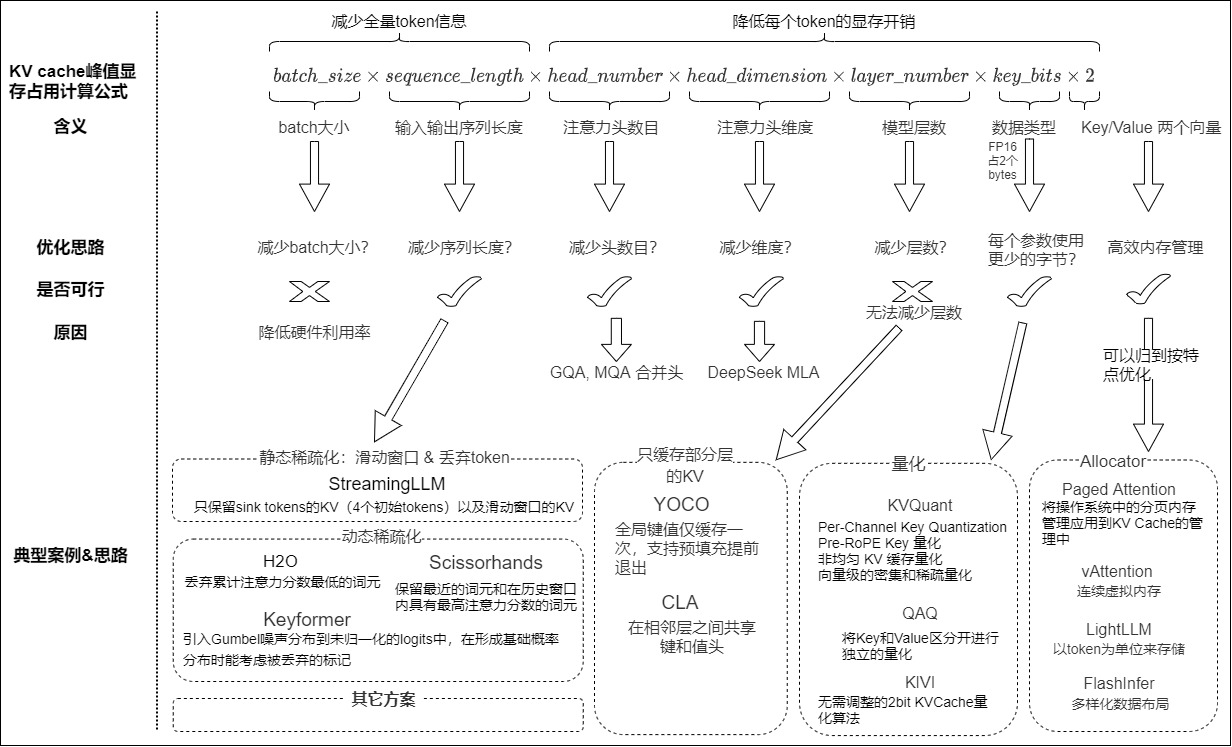
- 减少序列长度:针对超长 prompt,通过减少 kv cache 中 slot 的数量进行压缩,以此达到减少输入输出序列的长度(或者说是提示 + 完成部分)的目的。例如,对于长度为 128K tokens 的 prompt,仅挑选 1024 个 tokens 的 kv cache 进行存储。
**抛弃不重要的token(稀疏化):**通过 attention score或者attention的系数特征来判别不重要的token,然后把这些token对应的KV都抛弃掉。这部分研究跟LLM的量化一样,都在activation outlier提出来之后取得了比较大的进展。虽然这种方法可以提高效率,但存在丢弃关键词元的风险,特别是对于需要深入理解远距离上下文的任务。
静态稀疏化。在计算预测下一个 Token 时,只维护一个窗口大小的历史 Token 信息。然后通过调整注意力窗口来调整序列长度。静态稀疏化的窗口内的 Token 是固定的。静态稀疏化可以通过注意力机制来实现,即稀疏注意力机制或者线性注意力。稀疏注意力机制的核心思想就是在推理中选择合适的 Token 来进行相应的计算,这种方案在序列比较长时尤其有帮助,可以大幅降低 Attention 部分的 KV Cache 大小和计算量。线性注意力机制(如Linear Transformer、RWKV和Mamba等)通过将标准注意力机制替换为与序列长度线性相关的机制来减少内存需求。然而,这种方法可能会降低模型的表达能力,导致在需要复杂、长距离词元依赖关系的任务中性能下降。
- Window Attention:Window Attention采用滑动窗口机制来解决长文本推理挑战,其中落在窗口外的token被永久驱逐并变得无法访问。
- StreamingLLM:StreamingLLM 利用“注意力沉积”效应,用早期 Token 的KV结合近期上下文来优化长序列处理,实现了对无限长度输入的支持,同时生成无限长度的输出。
动态稀疏化。动态 Token 稀疏化本质是为当前处理 Token 维护一个相关性高的历史 Token 集合,但与静态 Token 稀疏化不同,这个集合的构造不再由 Token 距离或者固定 Token 决定,而是设计一种算法去筛选历史的 Token。静态 Token 稀疏化是动态 Token 稀疏化的子集,所以理论上动态 Token 稀疏化的效果会比静态 Token 稀疏化更好。
- H2O:论文”H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models“提出的H2O是比较经典的方案。H2O观察到,注意力计算主要由一组被称为重拳(“pivotal tokens”或“heavy hitters”)的高影响力token来驱动。因此,H2O将缓存优化重新表述为动态子模型问题,利用累积注意力得分来指导token保留决策。
- Keyformer:在生成推理中,大约90%的注意力权重集中在特定的一小部分token子集上,这些token被称为“关键”token。这些token对于大型语言模型(LLMs)理解上下文至关重要,但可能不在窗口注意力的滑动窗口内。Keyformer引入了一种混合注意力方法,如下图(d)所示,该方法在生成下一个token时结合了最近的token和前面的关键token。此外,Keyformer揭示了token移除会扭曲底层softmax概率分布。考虑到softmax分布在token显著性评估中的关键作用,Keyformer 结合了正则化技术来减轻这些分布扰动。
针对prefill阶段的稀疏化。主要是优化prompt的序列长度,取出其中重要的token。
- 现有的KV缓存压缩方法主要关注生成阶段的优化,忽略了输入阶段KV缓存的压缩。而实践中,大模型应用如对话(特别是RAG)和文档处理的特点是:输入很长,而输出相对较短。输入可能就已经把显存撑爆。或者即便显存还可以,每一步计算也会因为需要交互的token太多而非常慢。因此输入阶段的KV缓存是内存和计算瓶颈所在。比如我们输入的prompt有16K,那么存储这16K文本对应的所有KV,无论对于显存还是计算都有极大的压力。因此我们可以在prefill阶段对KV Cache进行处理,drop一些不重要的token,即压缩prompt生成的KV。而解码阶段就照常进行,这样不需要在解码阶段进行额外的计算,又可以加速。
针对层特点的稀疏化。LLM模型的注意力层有自己的特点,这也影响了KV Cache稀疏化策略。因此,在KV Cache管理中,即需要依据注意力权重的贡献进行区分处理或者累积处理,也需要动态调整每层参与注意力计算的键token数量。
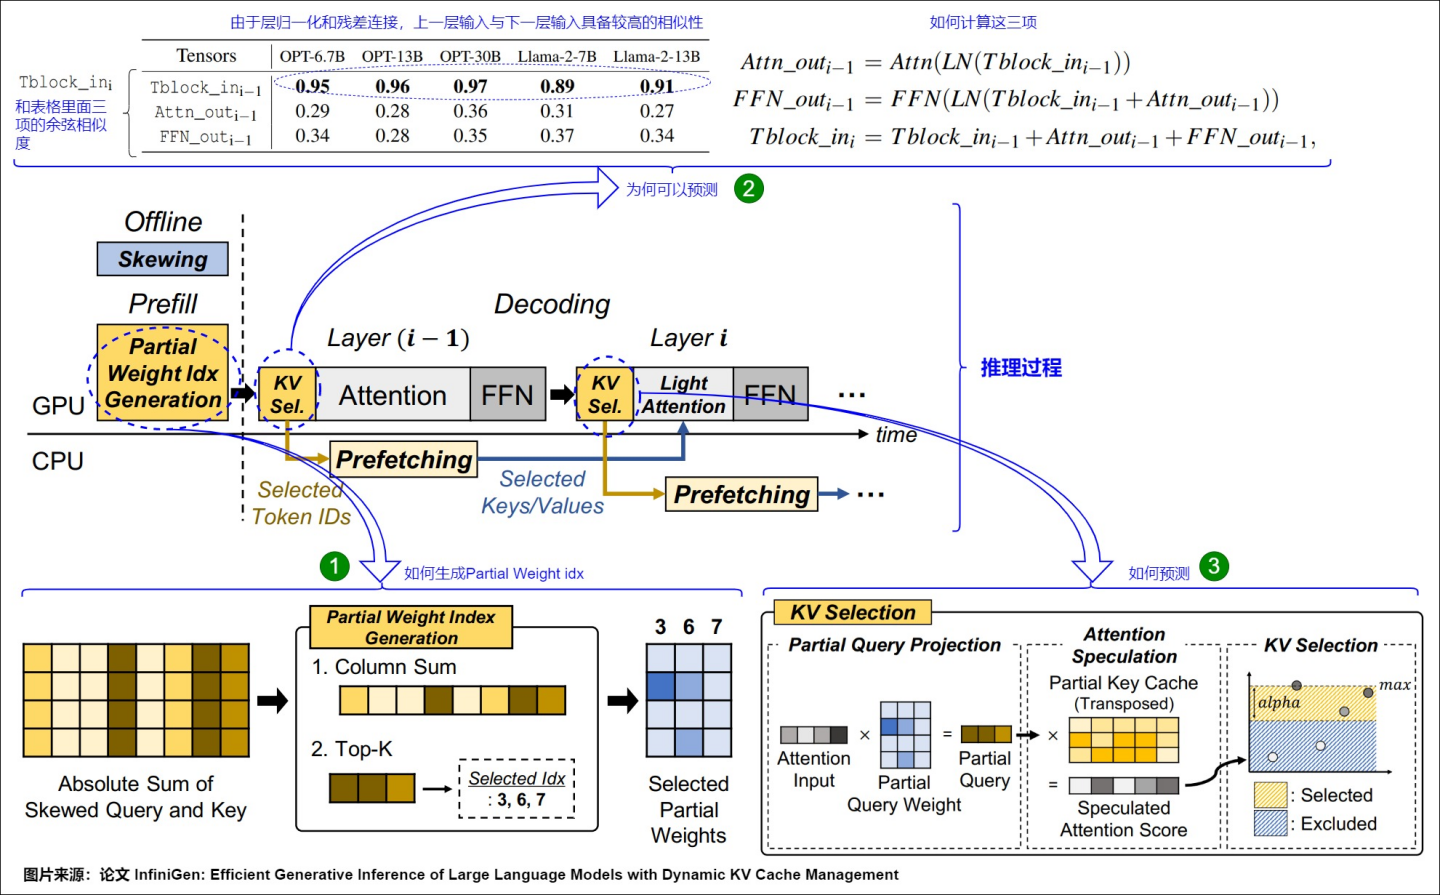
- LLM模型的注意力层有自己的特点,这也影响了KV Cache稀疏化策略。比如,为了估计需要保留多少KV Cache中的键/值,InfiGen作者对每个查询token的注意力权重按降序排序,并累计键token的权重,直到累计权重达到0.9。下图展示了在不同层(Layer 0 和 Layer 18)中,为了达到总注意力权重的0.9所需的键token数量分布情况。直方图的横轴表示键token数量,纵轴表示查询token的数量。
- PyramidKV:论文“PyramidKV: Dynamic KV Cache Compression based on Pyramidal Information Funneling” 通过研究不同layer间的注意力机制,探索了跨层共享kvcache的效果,发现较低层在输入序列中表现出均匀的注意力分布,而上层则表现出对特定token的集中注意力。因此,PyramidKV采用了金字塔形的内存分配策略,将更多的KV缓存分配给信息更加分散的较低层(前几层),每个KV包含的信息较少,同时减少较高层的KV缓存,使得高层中信息变得集中在较少的关键token中,同时在每一层选择具有高关注值的token。此外,在解码阶段,PyramidInfer通过由注意力值驱动的频繁更新动态维护一组重要token。
- PyramidInfer:PyramidInfer 也采用金字塔形的预算分配策略,同时在每一层选择具有高注意力值的token。此外,在解码阶段,PyramidInfer依据注意力值来更新动态维护重要token。
- ZigZagKV:ZigZagKV 其实是在SnapKV上继续做优化,也就是说,它也是输入prompt的KV Cache压缩算法,但是ZigZagKV依据层特点进行了稀疏化,因此放在此处。
- LCKV:LCKV 建议只计算和缓存一小部分层的键和值,甚至只计算顶层,然后让底层的查询与保存的键和值配对进行推理。这种方法不仅大大提高了推理速度,降低了内存消耗,而且与现有的内存节省技术正交,能够直接集成以进一步优化。虽然这种机制使下一个注意力计算依赖于前一个注意力的顶层密钥和值,这与Transformer的并行训练相矛盾,但LCKV引入了一种近似训练方法来支持并行训练。
其它方案。比如结合投机采样进行的稀疏化;针对头特点的稀疏化等。针对头特点的稀疏化进行更细粒度的逐头预算分配,它能够在每一层内的单个注意力头之间进行精确的内存分配,提供更灵活和有针对性的优化机会。
- AdaKV:基于注意力模式差异为各头分配缓存,通过优化L1损失界限最大化保留信息。
- RazorAttention:描述了两类不同的检索头。“回声(echo)头”专注于先前出现的相同token,“归纳(induction)头”关注与当前token重复的之前token。该框架实现了差异化缓存策略,为检索头维护完整的缓存条目,同时将远程注意力压缩为非检索头的合并补偿注意力。
- DuoAttention:DuoAttention引入了一种参数化方法来区分两类注意力机制:检索头,对全面的长上下文处理至关重要;流式头,主要处理最近的注意力和注意力吸收器。这种分类是通过学习参数实现的,这些参数可以自动识别需要全注意力的检索头。
- 投机采样稀疏化:通过draft模型生成候选token,然后选取其中重要的token。
- 聚类稀疏化:为了加速关键注意力的检索,一些研究工作提出了基于索引的方法,以块或集群(cluster )粒度组织和访问KV缓存,实现了高效的查询和提取操作。InfLLM在块中维护完整的KV缓存,同时通过分层存储策略促进长序列处理。该框架采用CPU-GPU内存编排,在GPU内存中保留基本注意力和当前计算单元,同时将访问频率较低的单元卸载到CPU内存中。为了进一步提高top-k块检索精度,Quest框架提出了一种基于KV缓存块中最小和最大键值的精细块表示方法。
**复用token:**通过复用来降低序列长度。比如复用system prompt等,这是一种工程优化,从算法层面上看,是一种无损优化,无需训练侧介入。
- 复用也是减少KV序列长度的一个重要手段。在本节,我们主要介绍两种方案:KV Cache合并(Merging)和前缀复用。
- 层间合并与层内合并
- Prompt Cache:论文“Prompt Cache: Modular Attention Reuse For Low-latency Inference“提出了Prompt Cache,这是一种通过在不同的 LLM 提示中重用注意力来加速[LLM)推理的方法。Prompt Cache 采用一种称为schema(议程)的方法来明确定义可重用的文本段,并将其称为提示模块。该schema可确保注意力重用期间的位置准确性。然后,Prompt Cache 在加载一个schema时填充其缓存。在推理时,如果这些“缓存”段出现在输入提示词中,系统使用内存中预先计算的键值注意力,只计算未缓存的文本。Prompt Cache在本质上也是以空间换时间的技术。
- ChunkAttention:ChunkAttention 将KV Cache分块组织为前缀树,支持运行时检测和共享多个请求之间的公共前缀,通过两阶段分区算法提升数据局部性。 具体而言,ChunkAttention通过将整体的键/值张量分解为较小的块,然后将它们结构化到辅助前缀树中。而且,ChunkAttention在基于前缀树的KV Cache基础之上,又实现了两阶段分区算法,这样在存在共享系统提示的情况下,可以增强自注意力计算时的数据局部性。
- AttentionStore:AttentionStore允许在同一对话的后续轮次中重用KV缓存,从而有效减少了多轮对话中的重复计算开销。为了提高AttentionStore的效率,其作者计了重叠KV缓存访问、分层放置KV缓存和位置编码解耦的KV缓存截断方案。
- RadixAttention:SGLang论文提出的RadixAttention技术是实现KV缓存重用的典型方案之一,也是高效内存管理的代表。与在生成请求完成后丢弃 KV 缓存的现有系统不同,RadixAttention会利用基数树实现了缓存的快速匹配、插入和替换。而且,在RadixAttention中,无论是Prefix还是Generate阶段产生的KV Cache,都会被缓存。这可以最大程度增加KV Cache被新请求复用的几率。作为对比,ChunkAttention只聚焦在prefix本身。
**基于检索(retrieval/取回)的方法:**比如把KVCache offload到cpu,以页或者聚类的形式组织。q和每个页或者聚类进行相似度计算来决定使用哪些页或者聚类。每次只把得分最高的top-k个页或者聚类加载到显存计算。
- InfiniGen:论文“InfiniGen: Efficient generative inference of large language models with dynamic KV cache management”通过预测机制,将KV Cache的主要部分卸载到CPU上,仅保留关键组件。在有新请求时,InfiniGen利用有限保留的信息(利用从上一层查询选择的重要KV条目的索引来检索当前层中的KV缓存条目)来推测性地将一小部分KV Cache重新加载到GPU上,从而在不影响性能的前提下,节省高速计算设备的内存空间,同时避免大量数据交换。InfiniGen是为了解决Offload中由于PCIe带宽不足带宽的推理延迟增加的问题。只是最后的解决方案是从算法的角度出发的。主要是节省decode的时间。
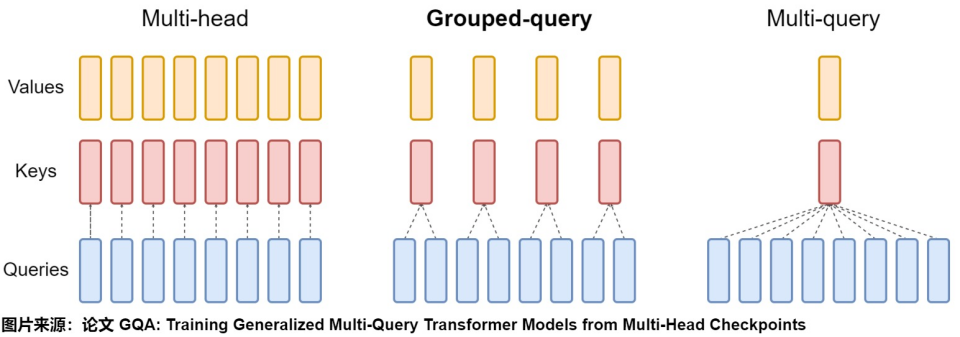
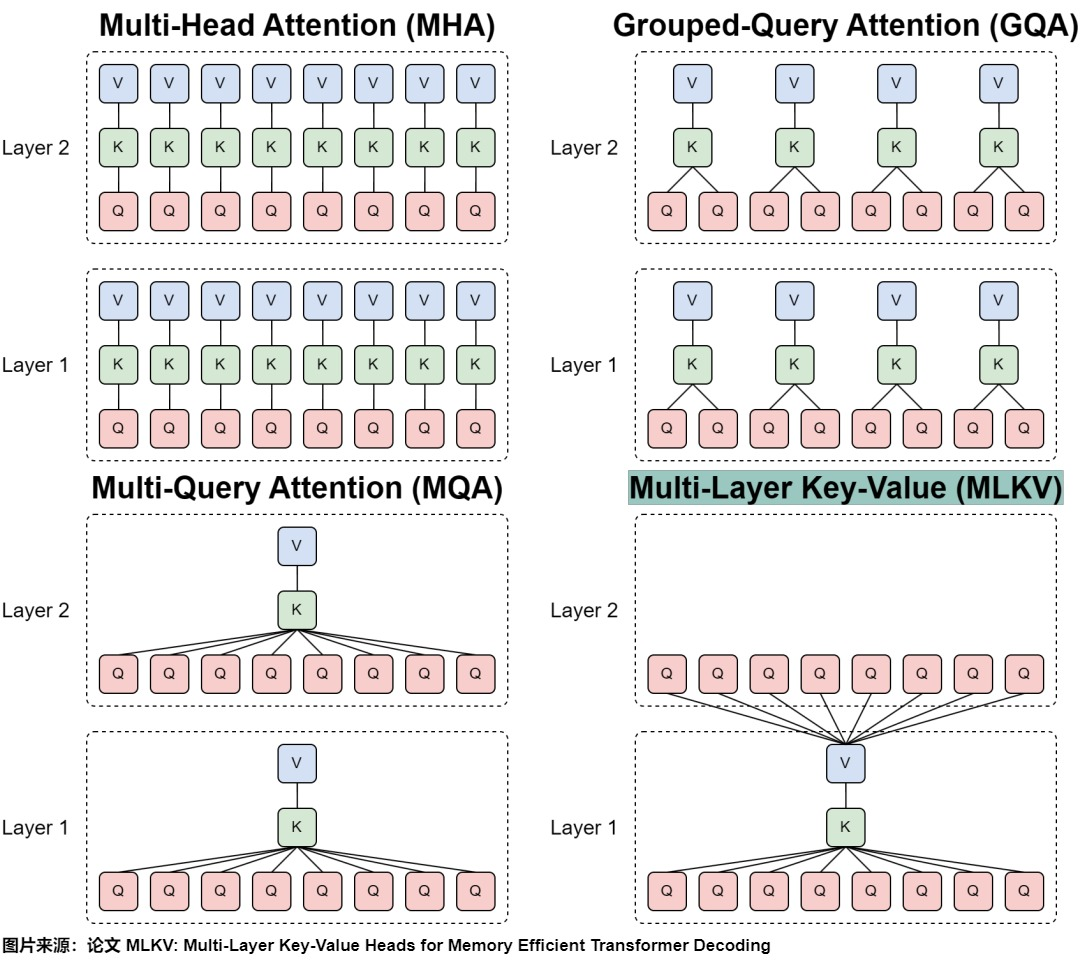
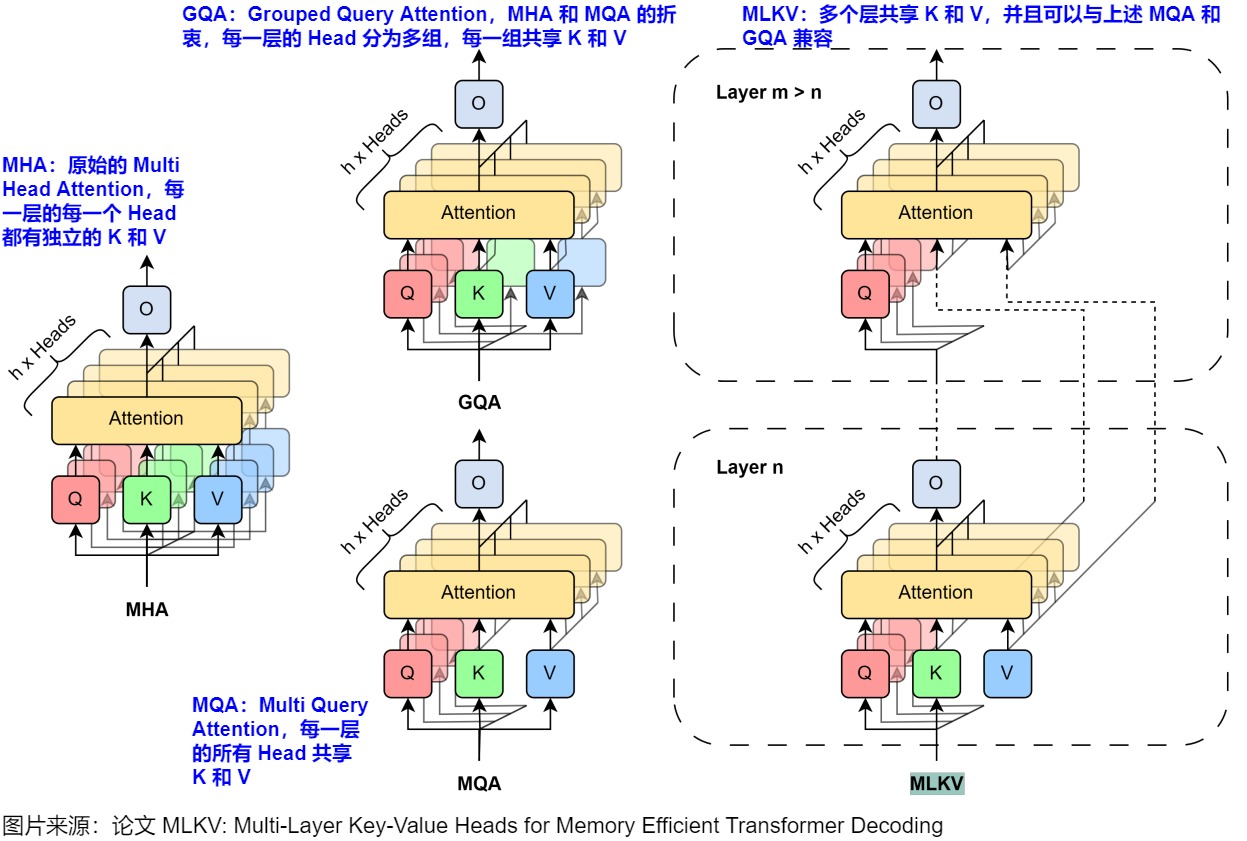
- 减少注意力头个数:MQA(multi-query attention)、GQA(Grouped-query attention)通过减少kv cache的head个数减少显存占用。
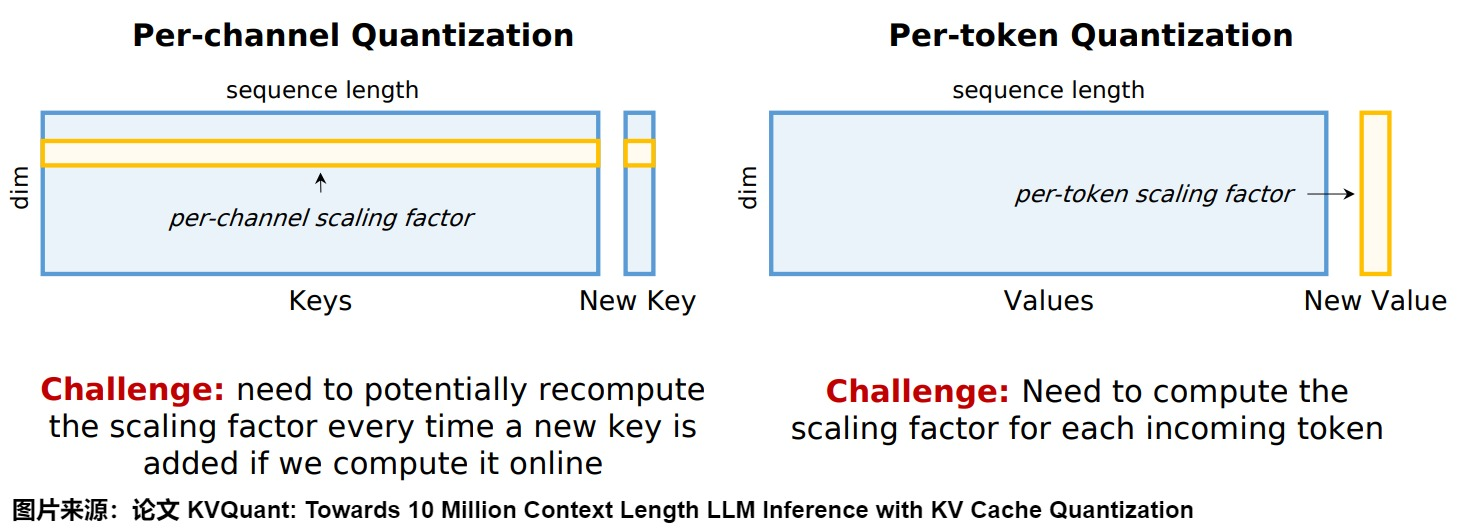
- 减少key_bits。因为FP16 占2个bytes,所以优化方式主要是量化,把模型参数由fp16转换到int8/int4,每个参数占用的字节也由2byte转换到1byte/0.5byte。在保持 kv cache slot 数量不变的情况下,将数据格式从 fp16 压缩到 int8 或 int4 等低精度格式。
- 减少头维度。DeepSeek V2的MLA引入了类似LoRA的想法,有效地减少了KV头的大小。Double Sparsity 将 Token 稀疏性和 Channel 稀疏性相结合:
- Token 稀疏性侧重于利用重要的 Token 来计算 Attention,也就是 Sequence 维度的稀疏。
- Channel 稀疏性是使用重要的 Channel 来识别重要的 Token,也就是 Hidden 维度的稀疏。
 作者的关键见解是:Channel 的稀疏性通常是相对静态的,可以通过离线校准的方式来执行,从而能够准确和高效的识别重要的 Token,使推理更高效。此外,这种方法可以与 Offload 结合,以显著减少内存占用。
- 减少 Layers:需要注意的是,此处不是真正的减少层数,而是只缓存模型部分层的KV,比如,逐层仅保留关键的上下文键和值,合并相邻层的KV Cache等。
- LayerSkip,利用“早退”+ 投机采样优化推理性能。其中,早退层(Early-exiting)是在模型的非最终的Transformer层进行 Unembedding 操作,相当于跳过了剩余的Transformer层。具体贡献为:
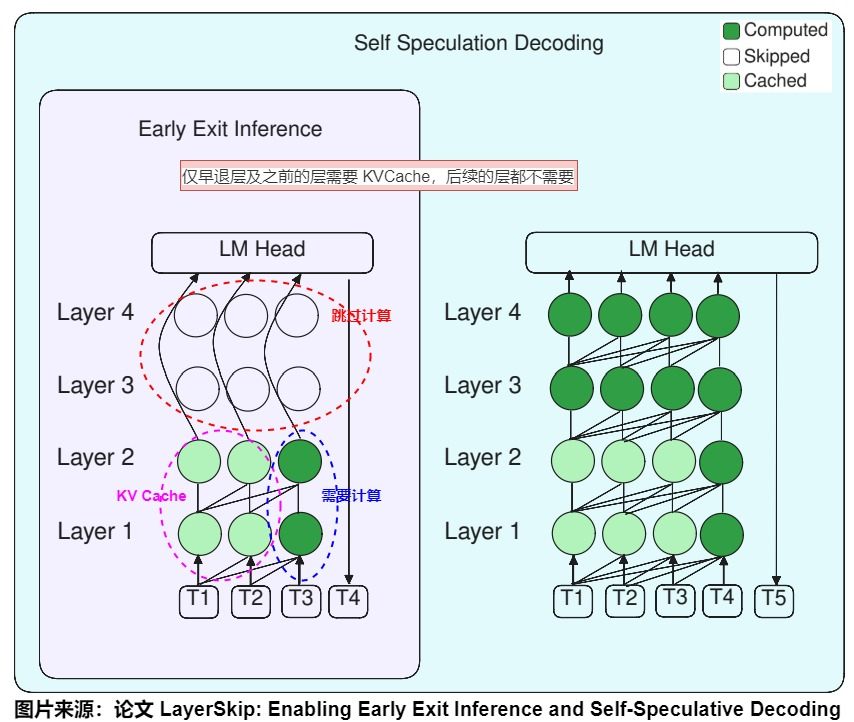 _ 训练侧:早退层没有和 LMHead 适配,导致生成效果很差,所以在训练时候需要前面的层适应早退,让模型具有一定的直接生成 Token 的能力。具体而言,训练时针对早退层添加了一个 Early Exit Loss,增强早退层的生成能力。
_ 推理侧:采用自投机解码策略,利用早退层推理速度快的特点来生成多个 draft tokens,然后验证阶段跑全量层,将通过验证的 draft tokens 返回。下图右侧所示的是自投机解码策略整体架构。浅绿色节点表示 缓存到显存的状态 KVCache,深绿色节点表示需要进行计算,透明节点表示跳过计算。通过下图可知,仅早退层及之前的层需要 KVCache,后续的层都不需要,所以 LayerSkip 有两大优化:加速预测性能;降低显存开销,潜在提升服务最大吞吐。
* YOCO 方案:论文”You Only Cache Once: Decoder-Decoder Architectures for Language Models“提出了YOCO方案,进行KV Cache跨层共享。选择固定的前几层来产生KV Cache。
    * YOCO 构建了一个由两个解码器模块组成的双解码器架构:自解码器和交叉解码器。自解码器有效地对全局键值缓存进行编码,而交叉解码器通过交叉注意重用这些缓存。整个模型的执行过程和 Decoder Only 的 Transformer 模型类似,但选择固定的前几层来产生KV Cache,只保留一层全局的 KV Cache。YOCO的计算流程还使预填充能够提前退出,从而在不改变最终输出的情况下实现更快的预填充阶段,降低GPU内存使用。 这种设计可以大大降低 GPU 显存的需求,同时保持了全局注意力能力。

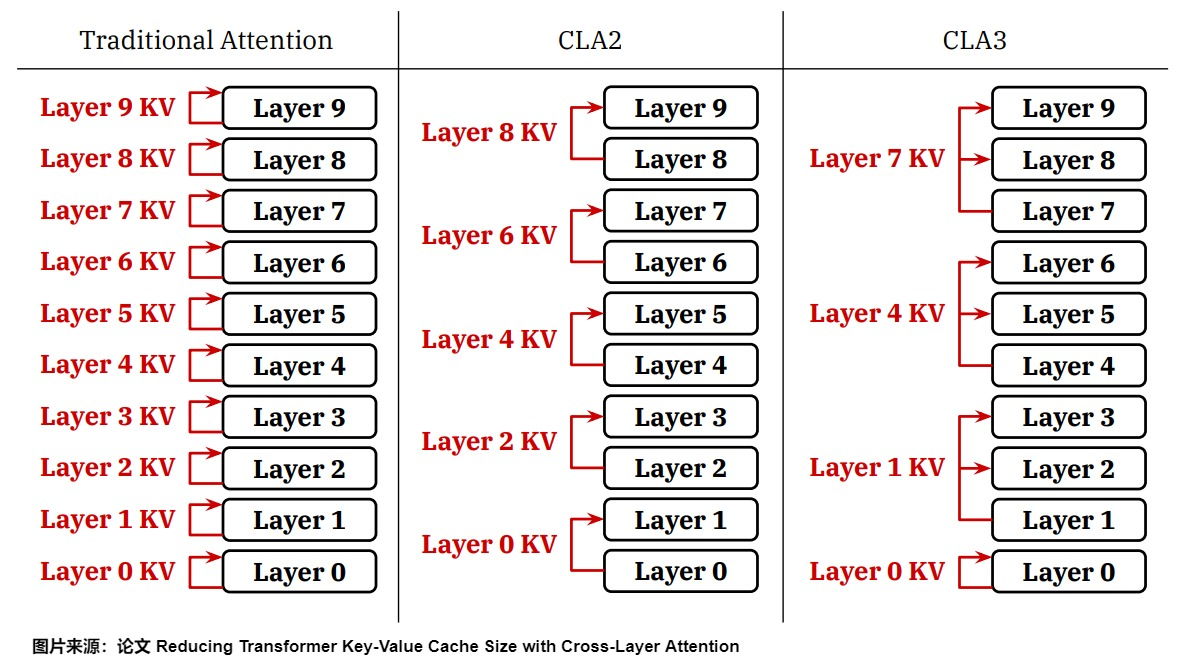
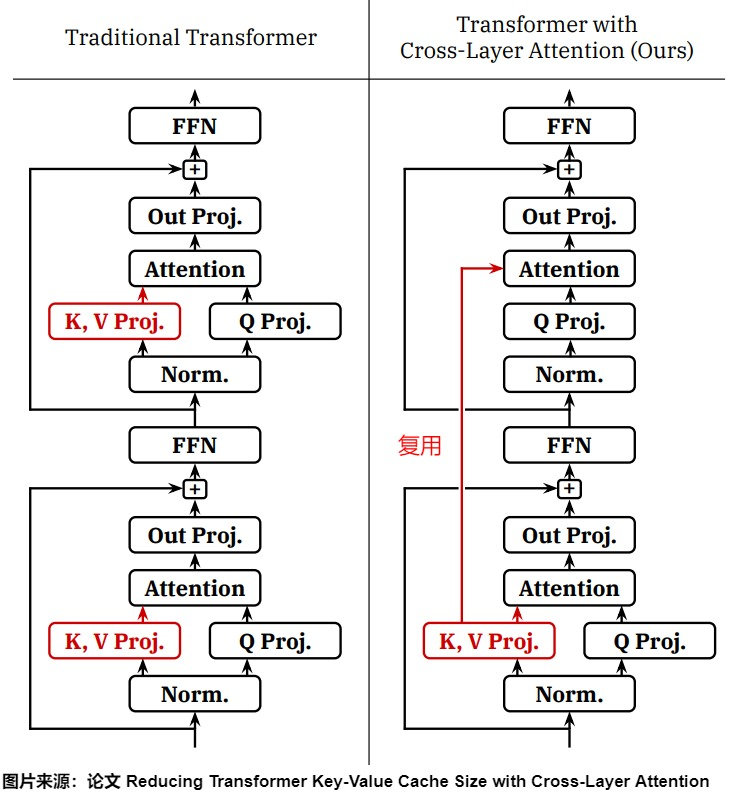
* CLA(跨层注意力):该方法将产生KV Cache的层交替分布在模型不同深度的层,然后通过在相邻层之间共享键和值头来扩展GQA和MQA的思想,进一步减少了KV缓存中的冗余。与MQA相比,CLA可以再减少2倍KV Cache大小,在不改变计算复杂性的情况下显著提高了内存效率。论文”Reducing Transformer Key-Value Cache Size with Cross-Layer Attention“提出了CLA( Cross-Layer Attention),即KV Cache跨层注意力,和YOCO思路不谋而合。和YOCO不一样的是,CLA并不是选择固定的前几层来产生KV Cache(比如YOCO,使用的是前L/2层),而是将产生KV Cache的层交替分布在模型不同深度的层,然后邻近层复用附近层产生的KV Cache进行Attention计算。
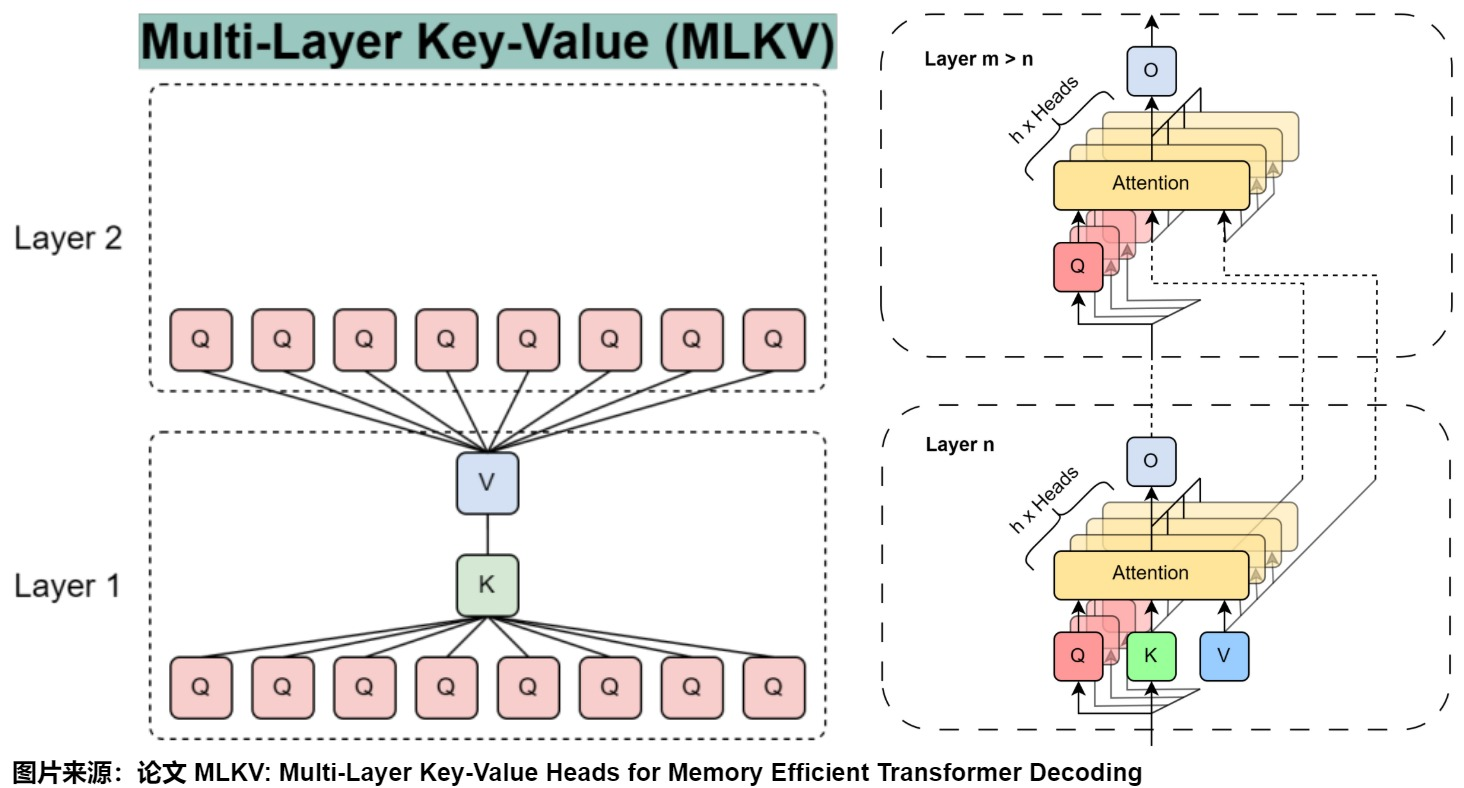
* MLKV:MLKV(多层键值/Multi-Layer Key-Value)引入了一种跨多个transformer 层的简单KV头共享机制。MLKV在一个层内使用与MQA相同的单个KV头,但它也与多个层共享这个KV头。这种极端策略将缓存大小减少到正常GQA策略的近1%,实验表明MLKV仍然具有相当的性能。从创新点上看,MLKV和YOCO都是CLA的特例。MLKV和CLA一样,都是做跨层的KV Cache共享,但MLKV主要是对MQA做更加极端的扩展,也就是MQA+跨层KV Cache共享,具体如下图所示。
- 优化 KV cache 的显存管理:目前GPU上KV Cache的有效存储率较低,可以通过类似PagedAttention的方法进行优化。
3.KV Cache 工程实践管理
3.1.SGLang
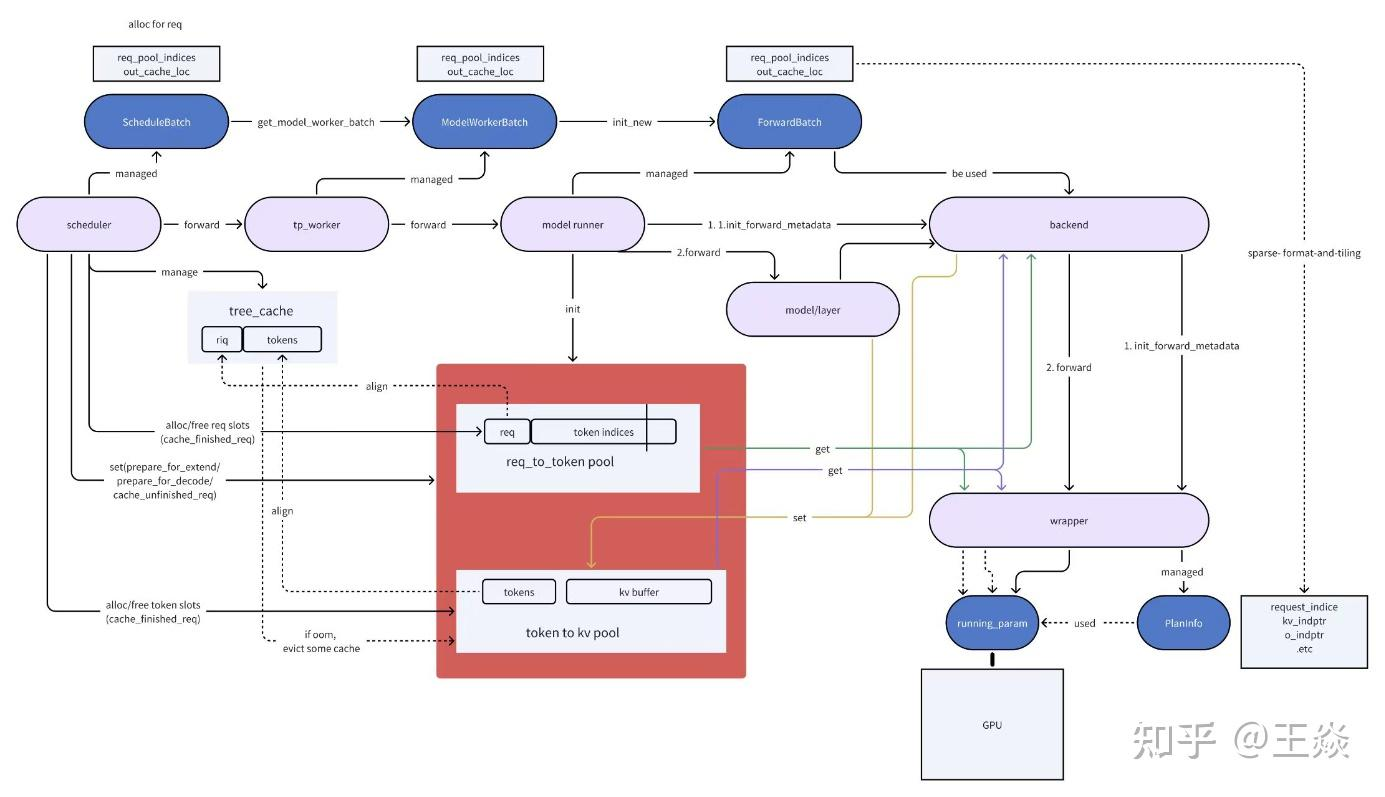
在SGLang中KV Cache 是在 Scheduler 各个流程中使用的。我们先简单介绍一下Scheduler调度大致流程,方便对KV Cache工作上下文有所了解。
Scheduler调度
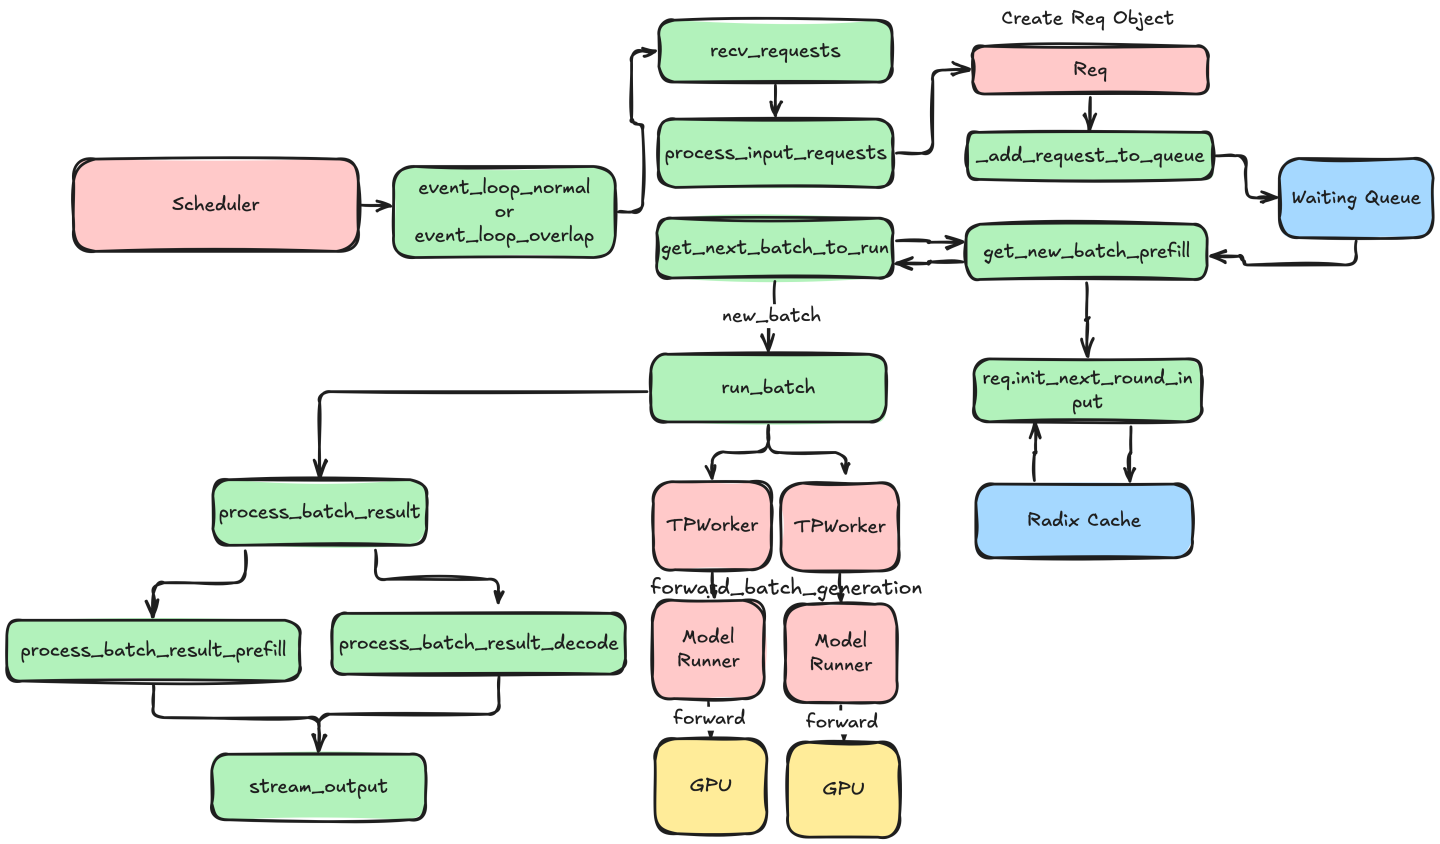 整体流程
**Event Loop:**Scheduler 不断执行由 process_input_requests、get_next_batch_to_run、run_batch 和 process_batch_result 构成的无限事件循环。
**process_input_requests:**遍历接收到的请求,识别其类型并将其分派给相应的处理函数。
get_next_batch_to_run
- 尽可能将 last_batch 与 running_batch 合并,并通过 get_new_batch_prefill 优先处理 prefill batch。
- 如果没有 prefill batch,则更新用于 decode batch 的 running_batch,包括过滤请求、管理显存并调整解码参数。
run_batch
- 对于生成模型,使用 TpModelWorker 的 forward_batch_generation 生成新的 token,或在空闲状态中使用 forward_batch_idle,并将结果返回至 event_loop_normal。
- 对于嵌入或奖励模型,执行 forward_batch_embedding,并返回 embeddings。
**process_batch_result:**在执行完 run_batch 后,Scheduler 在 event_loop_normal 中处理批量结果
- Decode 模式:处理输出,更新请求状态,处理标记和概率数据,管理内存,并记录统计信息。
- Extend 模式:处理预填充结果,处理输入标记,并为进一步解码或嵌入做准备。
- 已完成的请求通过 cache_finished_req 缓存,并流式传输到 DetokenizerManager。未完成的请求会被更新,并循环回 get_next_batch_to_run 进行进一步处理,直至完成。
KV Cache管理结构
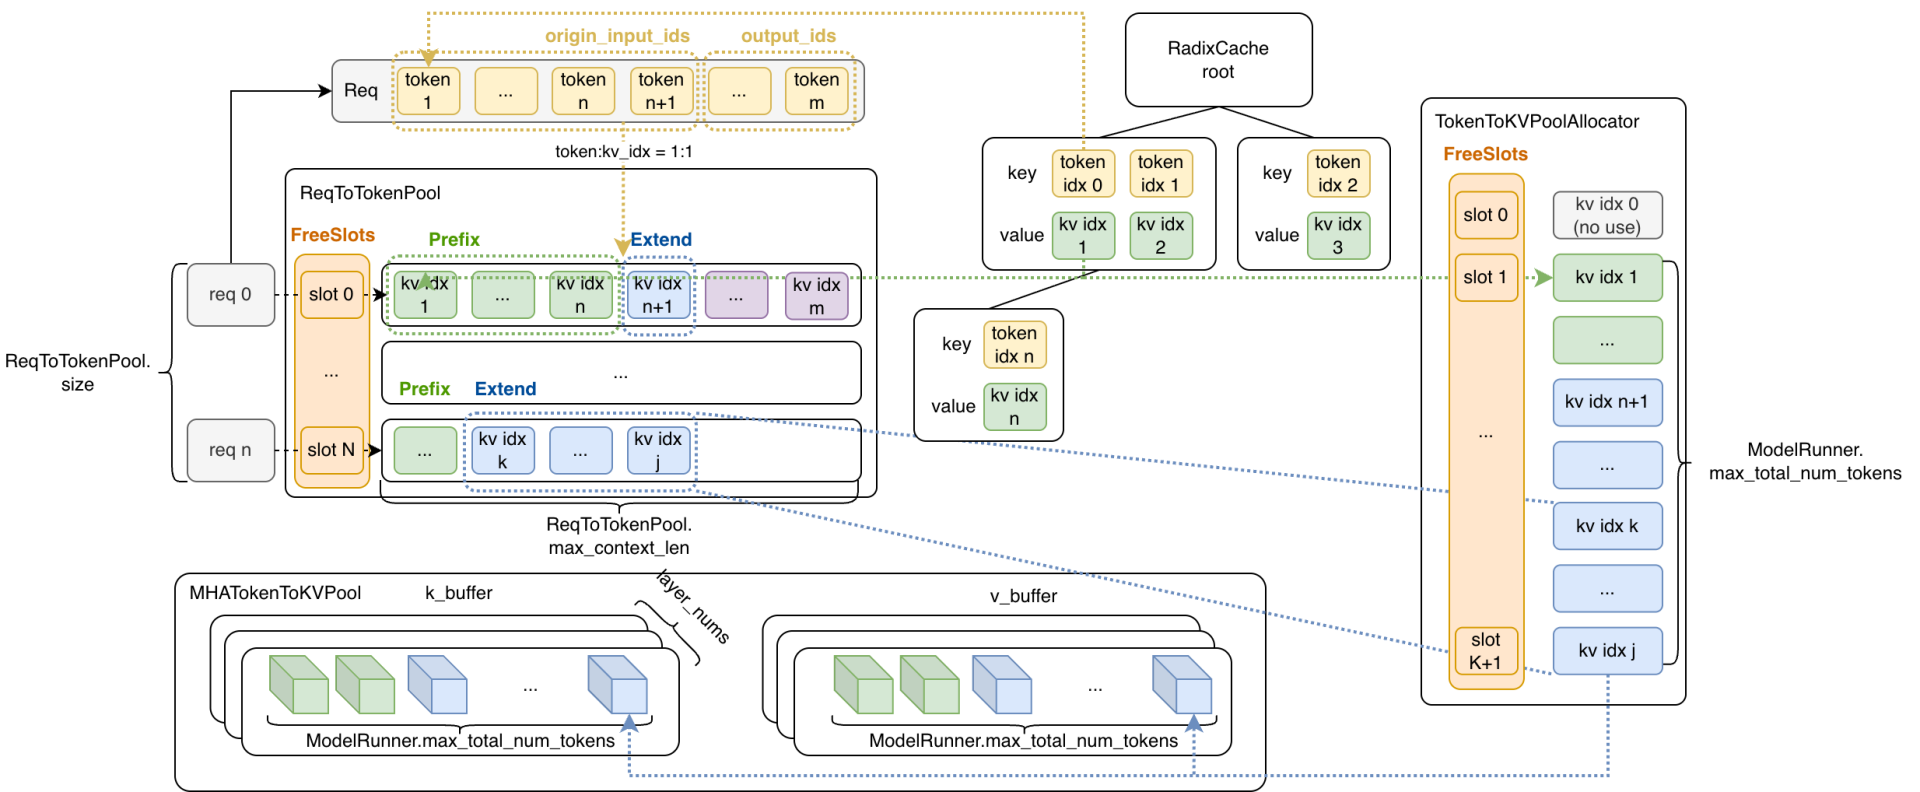
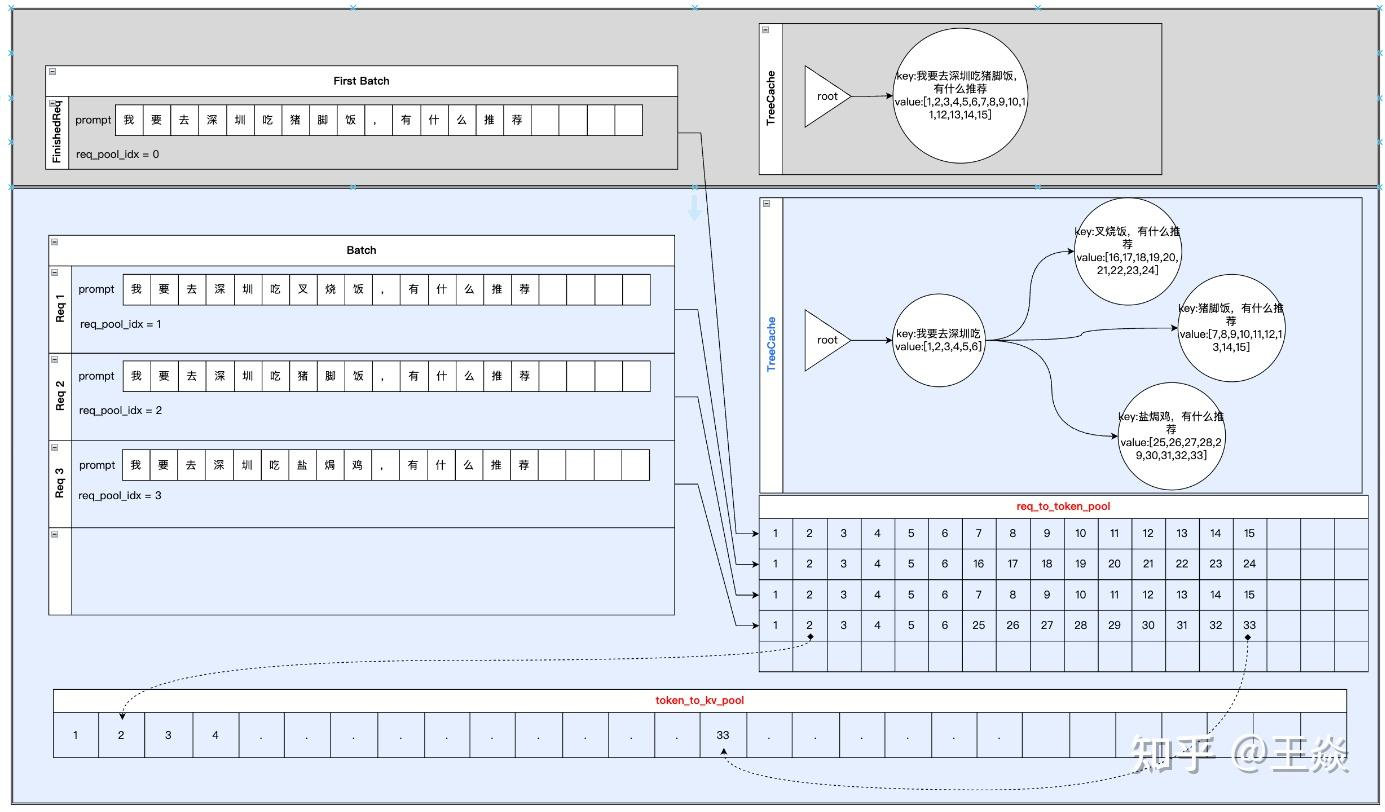
 SGLang中 KV Cache的管理采用了两级内存池:req_to_token_pool 和 token_to_kv_pool。
req_to_token_pool
- 用途: 将Request映射到其token的 KV cache的索引。
- 形状: 最大允许Request数(通过 max-running-requests 设置) * 最大允许 token 数(通过 model_config.context_len 设置)
- 访问:
- Dim0: req_pool_indices
- Dim1: 每个token在Request中的位置(0, 1, 2, …)
- 返回值:token 的 out_cache_loc
token_to_kv_pool
- 用途: 进一步将单个token从它的KV cache索引映射到其实际的KV cache数据。对于不同的注意力机制(如MHA、MLA、Double Sparsity),token_to_kv_pool可能有不同的实现。
- 形状: decoder层数 _ 最大允许 token 数 _ attention头数 * 每个attention头的维度
- 访问:
- Dim0:layer_id,该kv cache对应的层数
- Dim1:out_cache_loc,token对应的kv cache索引(req_to_token_pool的返回值)
- Dim2:注意力头
- Dim3:注意力头维度
- 返回值:cache_k & cache_v:实际的 KV cache数据
我们通常会一次性取一整个层的kv cache,因为在前向传播中需要Request中所有先前tokens的KV。
tree_cache
用途: tree_cache是一个树结构,用于加强跨Request之间的prefix KV cache复用。tree_cache 负责为每个请求在token级别更新req_to_token_pool 和 token_to_kv_pool。一个token在 tree_cache、req_to_token_pool 和 token_to_kv_pool 之间的数据可以通过其KV Cache 索引 (out_cache_loc) 相互映射。
访问:
- 键:Token ID。同一个token的KV Cache与request是无关的
- 值:Token 的 KV cache索引
实现:
- ChunkCache:关闭 radix cache 时的简化路径。
- PrefixCache:包括RadixCache和HiCache等多重实现
Backend
Attention Backend
以attention backend 视角,KV cache 主要表现为两件事:
- 读:根据已有 mapping/page table 找到历史 KV。
- 写:把本轮生成的新 KV 写进 out_cache_loc。
- 【 DeepSeek NSA 这类特化路径】写一份独立的 sparse index cache。
SGLang 的 attention backend 数量总计约 40 个相关类。比如:FlashInferAttnBackend、NativeSparseAttnBackend、DoubleSparseAttnBackend等
FFN/MLP Backend
Dense MLP(普通两层线性 + SwiGLU)
- Dense MLP 的 “backend” 本质就是量化/GEMM kernel 的选择,通过 –quantization xxx 控制。
MoE(多专家 + 路由)
MoE 比 dense 复杂,SGLang 拆成 Dispatcher(通信)× Runner(计算) 两层。
- MOE Dispatcher:通过–moe-a2a-backend 参数指定,支持:deepep、standard等。
- MOE Runner:可以通过–moe-runner-backend参数指定,支持:flashinfer_trtllm等。如果未显式指定,按 w8a8_int8 + kernel 可用性选)
Attention(MHA/GQA/MLA/Sparse/Mamba)
├─ 普通 MHA/GQA
│ └─ flashattention, flashinfer, triton, aiter, trtllm_mha,
│ torch_native, intel_amx, wave, xpu
├─ MLA 专用
│ └─ flashinfer_mla, flashmla, cutlass_mla, trtllm_mla, nsa
├─ 稀疏/长上下文/混合
│ └─ double_sparsity, dual_chunk_flashattention, hybrid_attn, tbo
└─ 线性 / SSM
└─ hybrid_linear_attn, mamba, fla

FFN/MLP
├─ Dense MLP(无独立 backend 抽象,由量化 kernel 决定)
│ └─ fp8, w8a8_int8, w4a16, awq, gptq, marlin, modelopt,
│ bitsandbytes, compressed_tensors, blockwise_int8 ...
└─ MoE
├─ Dispatcher(通信)
│ └─ standard, deepep, mooncake, mori, fuseep, flashinfer
├─ Runner(FFN kernel)
│ └─ triton, triton_kernels, deep_gemm, flashinfer_trtllm,
│ flashinfer_cutlass, flashinfer_cutedsl, marlin
└─ 整体融合实现
└─ cutlass_moe, cutlass_w4a8_moe, flashinfer_cutedsl_moe,
fused_moe_triton, ep_moe, kt_ep_wrapper
Scheduler与KV Cache关系
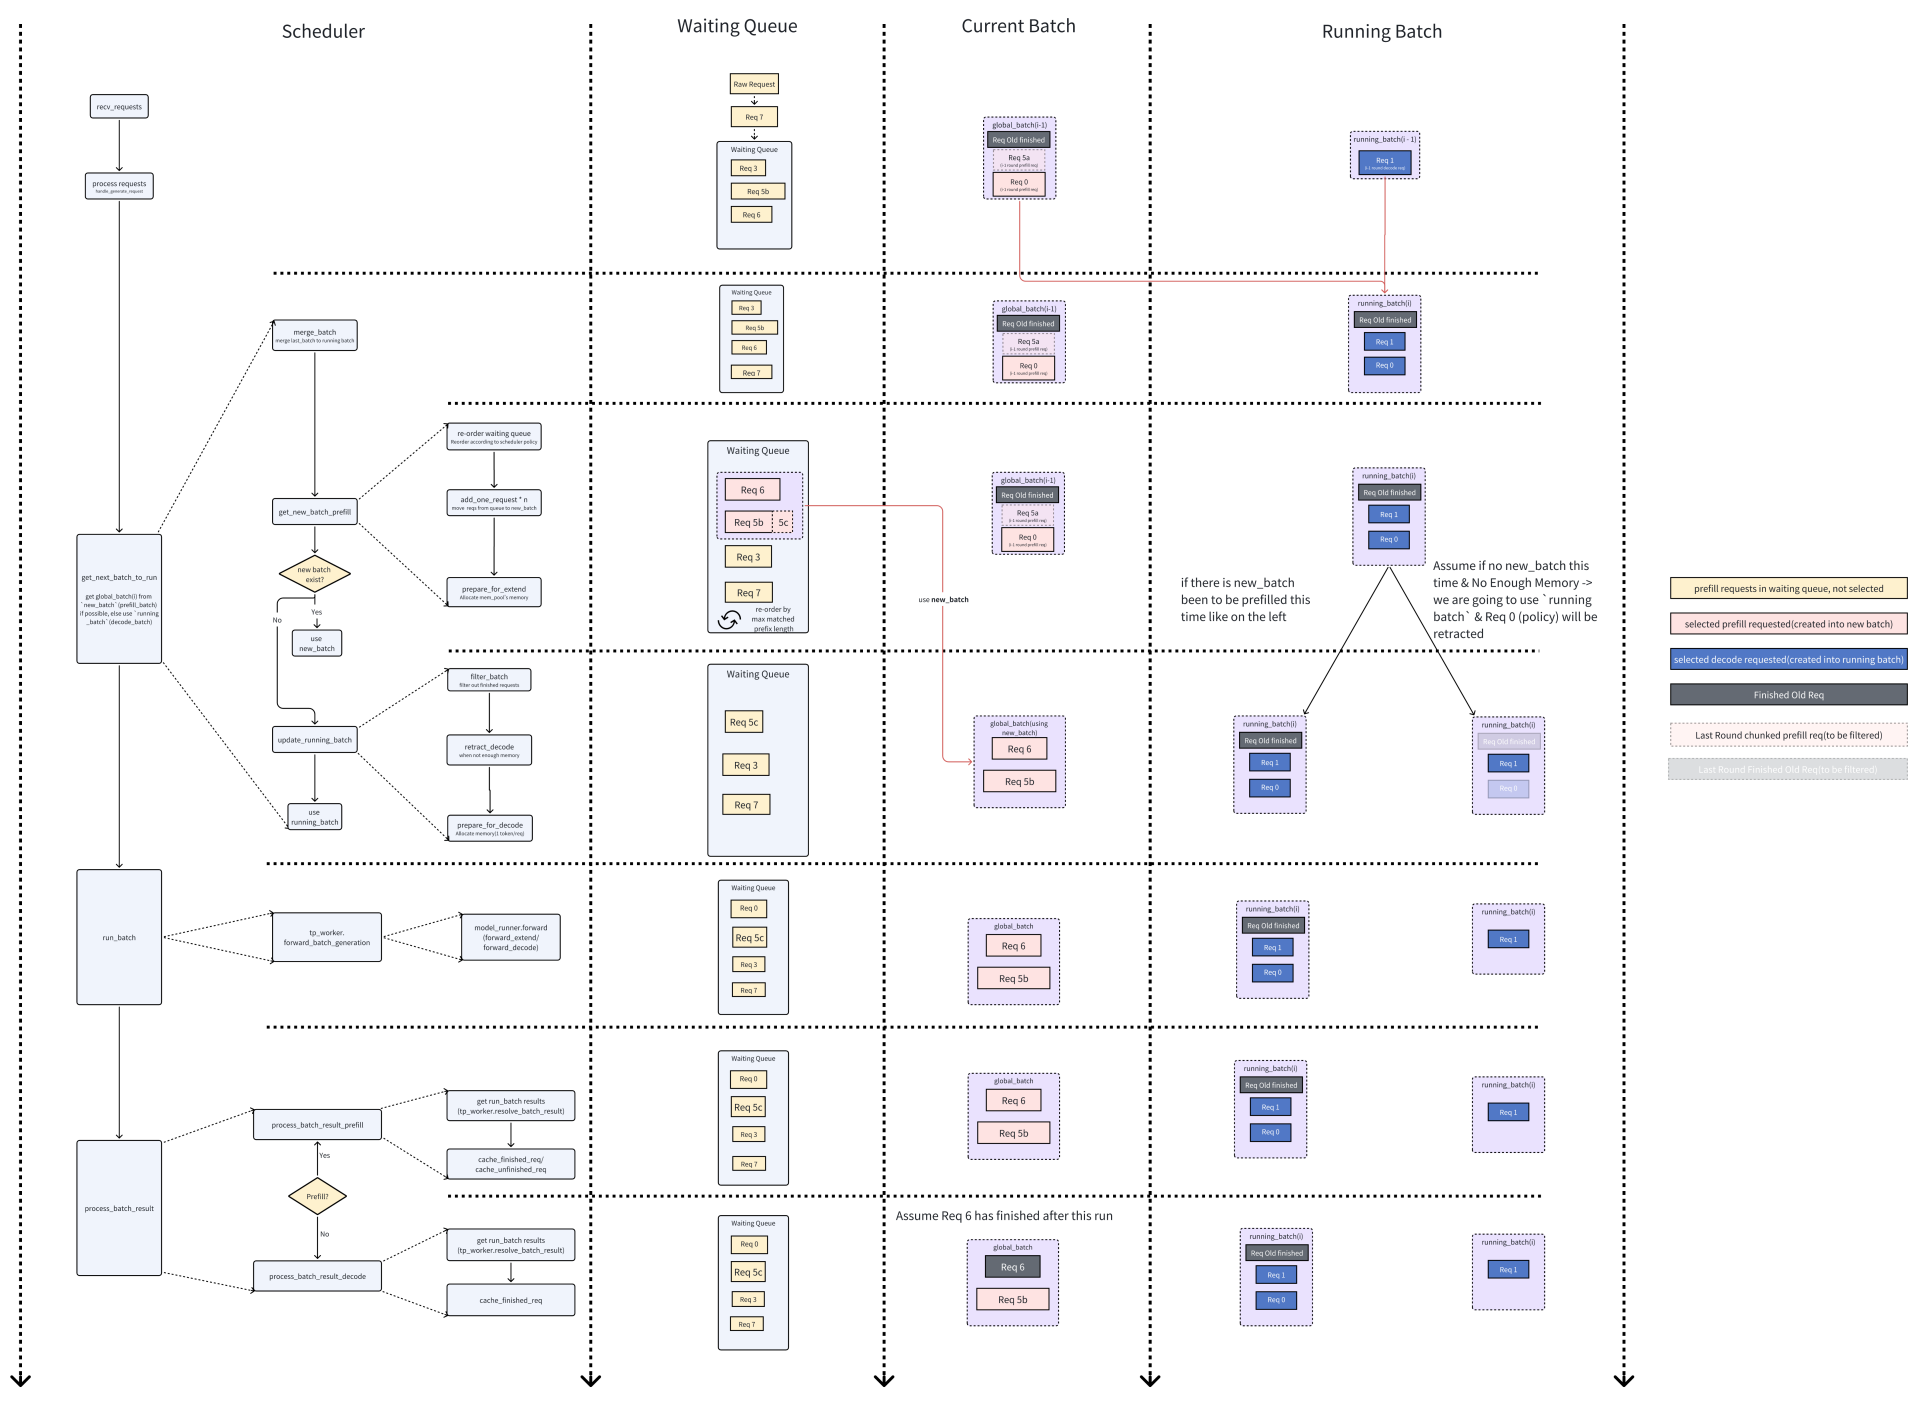
左图展示了 Scheduler 如何将Request从 waiting_queue 过渡到 new_batch(用于prefill/extend阶段),然后进入 running_batch(用于decode阶段)。
- 新Request到达:Scheduler 持续调用 recv_requests 以收集新到达的Request,验证它们并将其放入 waiting_queue。在我们的示例中,Req 7 被接收并入队。
- 合并批次:在为本轮形成新批次之前,Scheduler 会将上一轮的 cur_batch 合并到 running_batch 中。在图中,上一轮的 cur_batch 显示为 cur_batch(i-1),running_batch 显示为 running_batch(i-1)。在 我们的示例中,Req 0 和 Req 1 将合并到新的 running_batch 中。合并批次 还会移除上一轮的 being_chunked_request。being_chunked_request 是在 get_new_batch_prefill 过程中生成的分块预填充Request。(在图中,有已完成的 being_chunked_request,如 Req 5a,表示 Req 5 的第一部分),我们会移除它,因为我们不希望它们进入decode阶段。)
- 形成新批次:Scheduler 会检查是否可以形成一个 new_batch(在 get_new_batch_prefill 中),所有能适应可用内存的Request将被打包到批次中。如果最后一个放入批次的Request大小超过剩余可用内存,该Request将被分块为 being_chunked_request。在我们的示例图中,Scheduler 从 waiting_queue 中拉取Request并创建一个 new_batch(如 Req 6、Req 5b,Req 5b 是 being_chunked_request),并将 new_batch 用作 cur_batch。图中未展示,但如果没有 new_batch,running_batch 将被过滤(例如,Req 1、Req 0 将被保留,而 Old Finished Req 将被移除),然后用作 cur_batch。此外,如果 GPU 内存不足,某些decode Request可能会根据特定策略被retracted。在 retract_decode 阶段,图中 Req 0 被撤回。
- 运行批次:一旦确定了 全局批次,调用 run_batch 执行一次前向传递。
- 结果处理:在 run_batch 之后,Scheduler 调用 process_batch_result 来确定哪些Request已完成,哪些继续进行。在我们的示例中,Req 6 完成并变为灰色,Req 5b 仍未完成。
- 迭代:循环重复,直到所有Request最终完成。如果遇到内存不足,Request可能会被chuncked(prefill/extend)或在retracted(decode),然后重新插入 waiting_queue 以供后续处理。
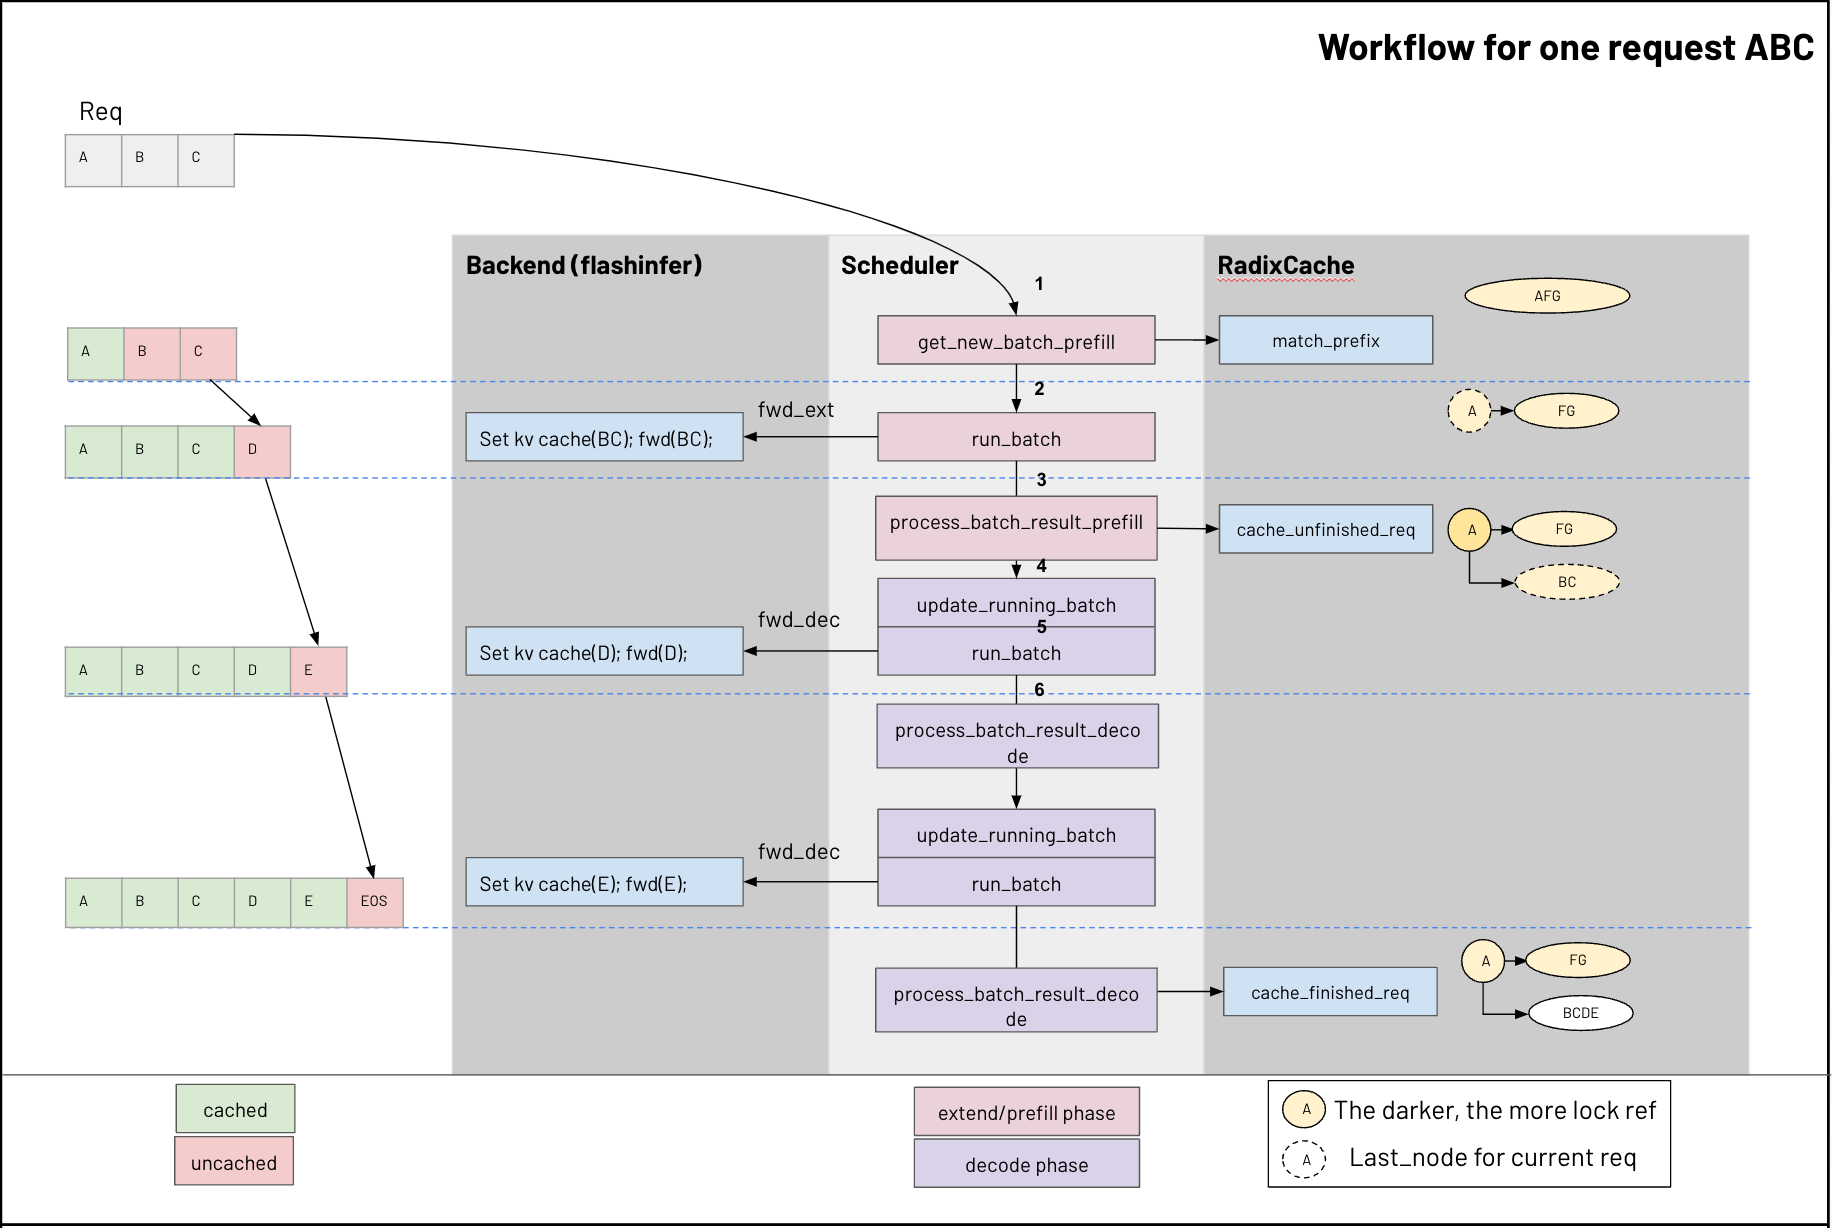
1. get_new_batch_prefill
更新radix tree cache里的前缀
- 当 Request ABC到达时,假设当前radix cache里存在一个节点AFG
- match_prefix 会尝试在当前radix cache里找到现存的ABC的最长前缀,也就是说它会在AFG节点里找到A
- Radix cache会把这个节点AFG拆分成A和FG,A节点成为当前Request的最后一个节点
调用 prepare_for_extend
req_to_token_pool
- 分配req_pool_indices
- 将前缀添加到req_to_token_pool
token_to_kv_pool
- 分配【每个Request的总input token数 - match到的prefixtoken数】个out_cache_loc
- 在左图的例子中,Request ABC的batch size为1
- 总input token数 = 3 -> A,B,C
- match到的prefix token数 = 1 -> A
- 因此会分配2个out_cache_loc给token B, C
2. run_batch
在当前batch上执行 forward_extend,这个到底层会调用到attention后端,attention后端负责:
设置要扩展(extend)的tokens的kv cache
- 把扩展tokens的kv cache设置到token_to_kv_pool (save_kv_cache)
- 在左图的例子中,我们在out_cache_loc中为B, C分配了两个位置,他们对应的K, V会被设置到这两个位置
运行forward attention计算,输入将是:
- Q = 扩展tokens,在上图的例子中是B, C
- K, V = 通过out_cache_loc 从 req_to_token_pool 里获取的所有cached tokens,包括 A(cache好的prefix token)、B、C(扩展 token)(create_flashinfer_kv_indices_triton)。
3. process_batch_result_prefill
cache_finished_req 和 cache_unfinished_req 负责管理Radix Cache、req_to_token_pool 和 token_to_kv_pool 的KV cache。
- 如果Request已经完成了,调用 cache_finished_req
- 如果请求未完成,调用 cache_unfinished_req
在我们的例子中,cache_unfinished_req 在extend/prefill阶段之后被调用,BC 被添加为 A 的子节点,两个节点 A 和 BC 的锁引用次数增加,节点 BC 成为当前请求的 last_node。
4. update_running_batch
- 调用 prepare_for_decode
- req_to_token_pool:不变
- token_to_kv_pool
- 为 out_cache_loc 分配(batch size * 1)个slot,因为在decode模式下我们对每个batch一次只生成一个token
- 在上图的例子中,在生成token D的轮次中,我们会为token D分配1个out_cache_loc
5. run_batch
在当前batch上执行 forward_decode,这个到底层会调用到attention后端,attention后端负责:
保存decode token的kv cache
- 将decode token的kv cache保存到token_to_kv_pool(save_kv_cache)
- 在上图的例子中,在生成token D的迭代中,token D对应的K, V会被保存到上述第4步里为它分配的out_cache_loc
运行forward,输入将是:
- Q = decode token,在上图的例子中是token D
- KV = 从req_to_token_pool中通过out_cache_loc获取的所有cached tokens,包括 A, B, C(来自之前的迭代),D(create_flashinfer_kv_indices_triton)。
6. process_batch_result_decode
如果Request已经完成了,调用 cache_finished_req;如果一个在decode阶段的Request还未完成,我们不需要对cache进行任何操作。
在左图的例子中,DE会被append到BC节点(变成BCDE),节点A和BCDE的锁引用次数减少。
HiCache
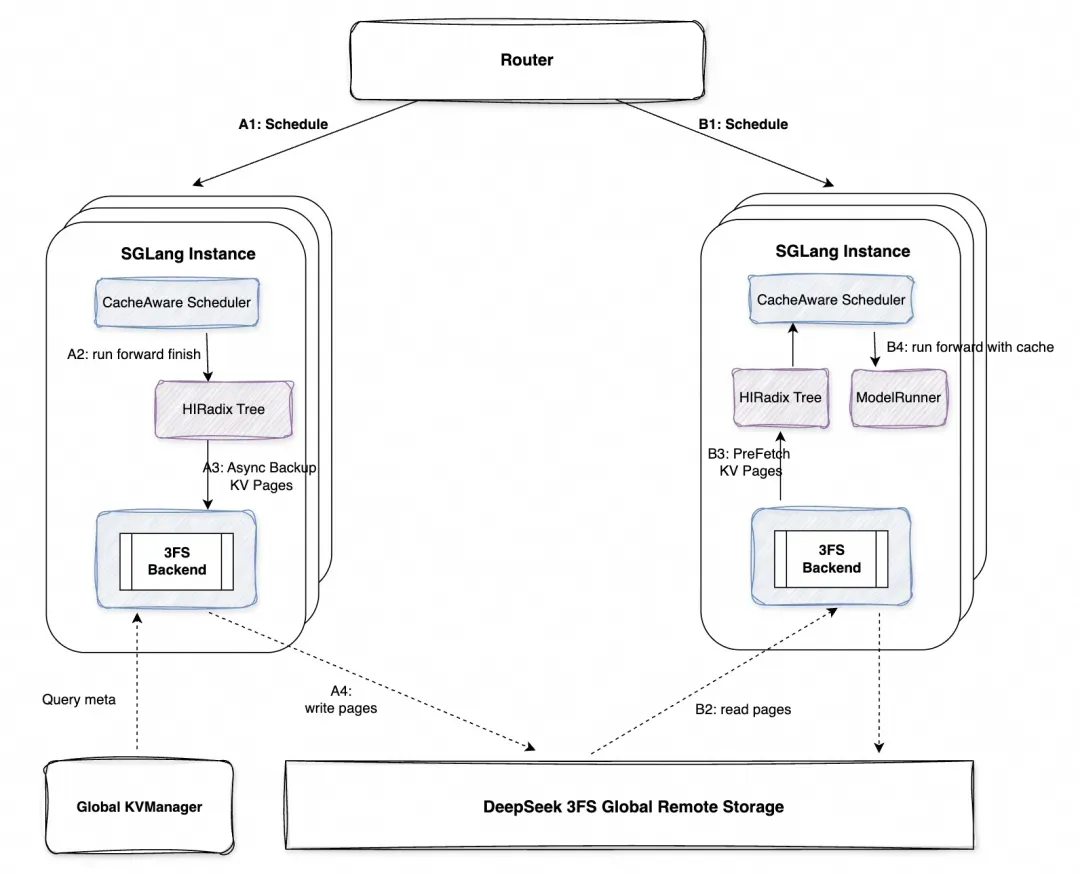
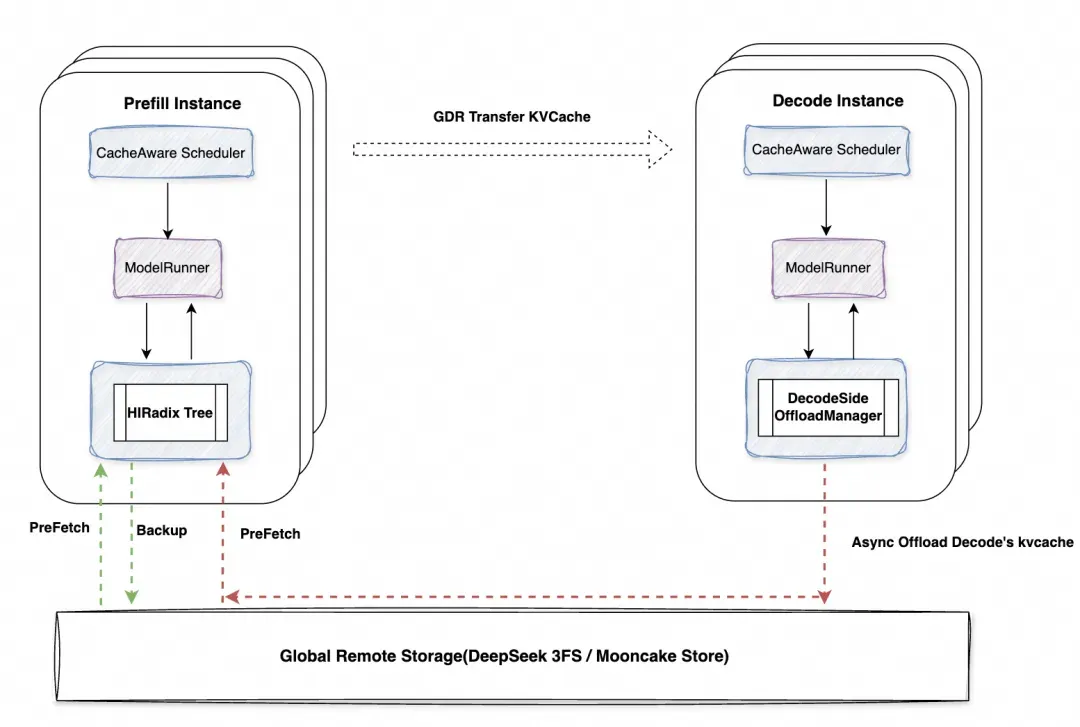
模块功能说明:
- HiRadixTree:GPU/CPU 双层前缀缓存树结构,原生支持 KVCache 在 GPU 与 CPU 之间的自动同步
- Storage Backend:可插拔的存储后端抽象层,当前已集成 3FS、Mooncake、NIXL 等后端实现。通过统一接口封装 batch_get / batch_set / batch_exists 等操作,支持零拷贝数据传输,兼顾高吞吐与低延迟
- Global KVManager:提供分布式文件系统(FS)的元数据统一管理服务,具备高效的元数据组织、查询与协调能力,为全局 KVCache 提供一致性管理
- 3FS Global Storage: DeepSeek 开源的高性能分布式文件系统,采用存算分离架构,结合 RDMA 网络优化与 NVMe SSD,提供 TiB/s 级别的聚合读取带宽,作为 HiCache 的持久化存储底座。
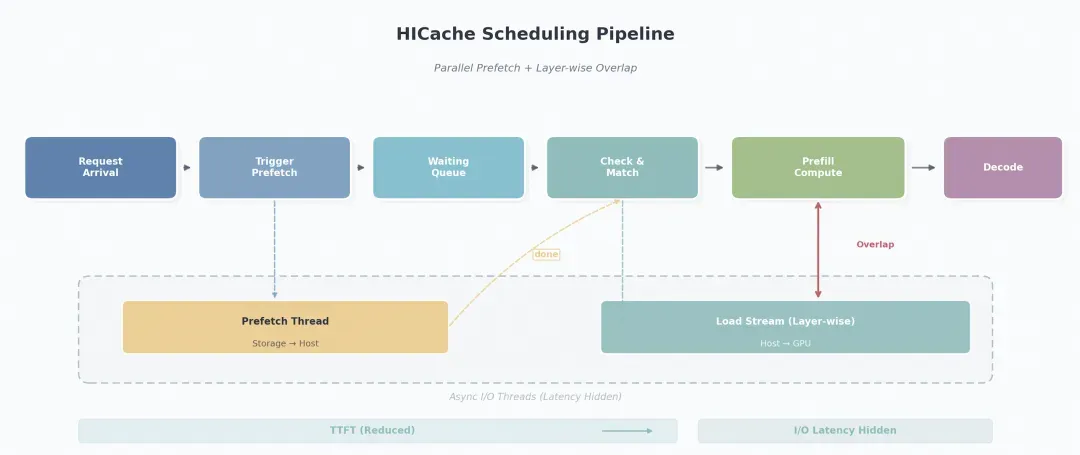
在原始调度模式下,请求从入队到首 Token 生成需要经历"等待 → 前缀匹配 → 显存分配 → Prefill 计算"全流程,其中 KVCache 仅存在于 GPU 显存。HiCache 模式通过引入三层存储架构与异步流水线,实现了两个关键优化:
- 预取与等待并行:
- 请求入队时即触发 prefetch_from_storage,在等待调度期间,后台线程已将 Storage 中命中的 KV 数据异步加载至 Host 内存,有效利用排队等待的"空闲"时间;
- Scheduler 调度到请求时根据调度策略终止请求prefetch/跳过请求调度。支持的调度策略:
- Best_effort:尽力而为,当调度到请求r时,如果r仍在prefetch则终止r,调度进入推理;
- Timeout:基于预计耗时终止请求,当调度到请求r时,如果r仍在prefetch且耗时超过预定义阈值则终止r,否则跳过r的调度本轮不进行推理;
- Wait_complete:prefetch 完所有kvcache才进入推理调度,否则跳过。
- 加载与计算 Overlap:当请求被调度执行时,Host → GPU 的 KV 加载通过独立 CUDA Stream 逐层进行(load_to_device_per_layer),模型前向计算可在第 i 层 KV 就绪后立即开始,无需等待全部层加载完成,实现计算与传输的流水线重叠。
这一设计将原本阻塞的 I/O 开销隐藏于调度等待与 GPU 计算之中,在显著扩展有效缓存容量的同时,最大程度降低了对首 Token 延迟(TTFT)的影响。
稀疏化
解决的问题:在 decode 阶段,是否可以只挑一部分“重要 KV 页”参与注意力,而不是总是访问完整历史。
Sliding Window Attention(SWA)
每 query 只看最近 window_size 个 token 的 KV,超出窗口的 KV 可以被驱逐掉。这是稀疏 KV cache 里唯一会真正缩小 KV 占用的。
工作流:
- SWA 层 KV 放小池 + 滑窗即时释放 + tombstone 保留前缀命中能力"——计算上靠 attention kernel 的 window mask,显存上靠双池 + 双 LRU + tombstone,三者协作完成"窗口外 KV 真正回收、前缀仍可共享"的效果
① 模型声明
config.sliding_window = W,每层标记 full / swa
│
▼
② KV 双池
SWAKVPool = { full_pool(大), swa_pool(按W) }
│
▼
③ Prefill / Decode 每一步
┌─────────────────────────────────────────┐
│ a. 前缀匹配 │
│ SWARadixCache.match_prefix(tokens) │
│ → 命中 full KV(可能很长) │
│ → 命中 swa KV(最多最近 W) │
│ │
│ b. 分配新 token 槽位 │
│ full_pool.alloc() + swa_pool.alloc() │
│ │
│ c. 算 attention(带 window mask) │
│ full 层:读 full_pool │
│ swa 层:读 swa_pool(仅 W 内) │
│ │
│ d. 滑窗回收 │
│ seq_len > W 时,swa_pool 释放最老格 │
│ 对应节点置 swa_tombstone │
│ (full 层 KV 不动,前缀仍可复用) │
└─────────────────────────────────────────┘
│
▼
④ 请求结束 / 显存紧张
双 LRU 驱逐:先驱 swa(便宜),再驱 full(彻底删节点)
**DeepSeek NSA **
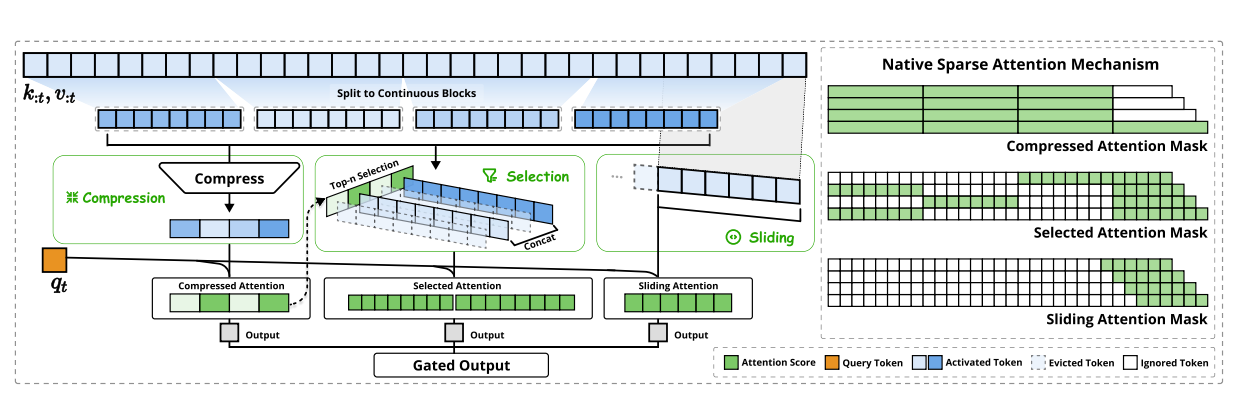 KV Cache 全存、attention 只读一部分。与SWA不一致。
工作流程:
- Indexer 按 page 打分选 Top-K + Compressed 全局摘要 + Sliding 局部窗口"三路融合的稀疏 MLA。KV 不删,只是 attention 读 KV 从 O(seq) 降到 O(K·page + W + seq/L);长序列下算力和 KV 带宽都大幅下降
① 模型层:每个 attention 是 MLA + NSA 三路结构
┌──────────── Q ─────────────┐
│ │
▼ ▼
Indexer 打分(轻量模块) 三路 attention 并行
│ │
│ 对每个 page 打分 ├─ Compressed 路:
▼ │ 历史 KV 聚合成"摘要页"
Top-K page 索引 │ 全看,代价低
│ │
▼ ├─ Selected 路:
Gather 选中的 page 的 KV │ 按 indexer 的 Top-K 索引
│ │ 只读选中 page → FlashMLA
▼ │
Sparse MLA kernel └─ Sliding 路:
(flashmla_sparse / tilelang) 最近 W token 的 KV,精确

        三路输出加权融合 → 层输出

===================================================
② KV Pool / Cache
KV 依然是 paged MLA 全量保存(page_size=64)
——NSA 不删 KV,只是"计算时只读一部分"
tree_cache 可选 RadixCache / HiRadixCache / ChunkCache
(你的 prefill 命令用了 --disable-radix-cache → ChunkCache)

===================================================
③ 每步 forward 的执行流
a. 常规 scheduler / allocator 分配 KV 页
b. AttentionBackend = nsa_backend.NativeSparseAttnBackend
init_forward_metadata: - 建 page 表 - 建 indexer metadata(compressed/selected/sliding 各自的 page list)- 准备 Top-K 缓冲(decode 时每步重算)
c. 每层:
indexer.forward(Q, K_index) → scores → topk_page_ids
├─ prefill: nsa_prefill_backend (默认 flashmla_auto / tilelang)
└─ decode : nsa_decode_backend (默认 flashmla_kv)
三路 kernel 并行跑,结果加权合并
d. 新算的 K/V 写回 paged KV pool
3.2.vLLM
3.2.1 PagedAttention
KV Cache 管理逻辑以 PagedAttention 为基础进行构建,分为逻辑层与物理层,该方式类似于操作系统的虚拟内存(virtual memory)管理。虽然 vLLM 版本在快速迭代更新,但这个基础逻辑保持一致,因此学习 PagedAttention 是了解 KV Cache 管理的第一步。
PagedAttention 的核心是一张表,类似于 OS 的 page table,这里叫 Block Table,记录每个 seq 的 KV Cache 分布在哪个 Physical KV block 上。通过将每个 seq 的 KV Cache 划分为固定大小的 Physical block,每个 Block 包含了某几个 token 的 KV Cache,允许逻辑上连续的 KV Cache 在物理层面不连续分布,从而提升显存利用率。
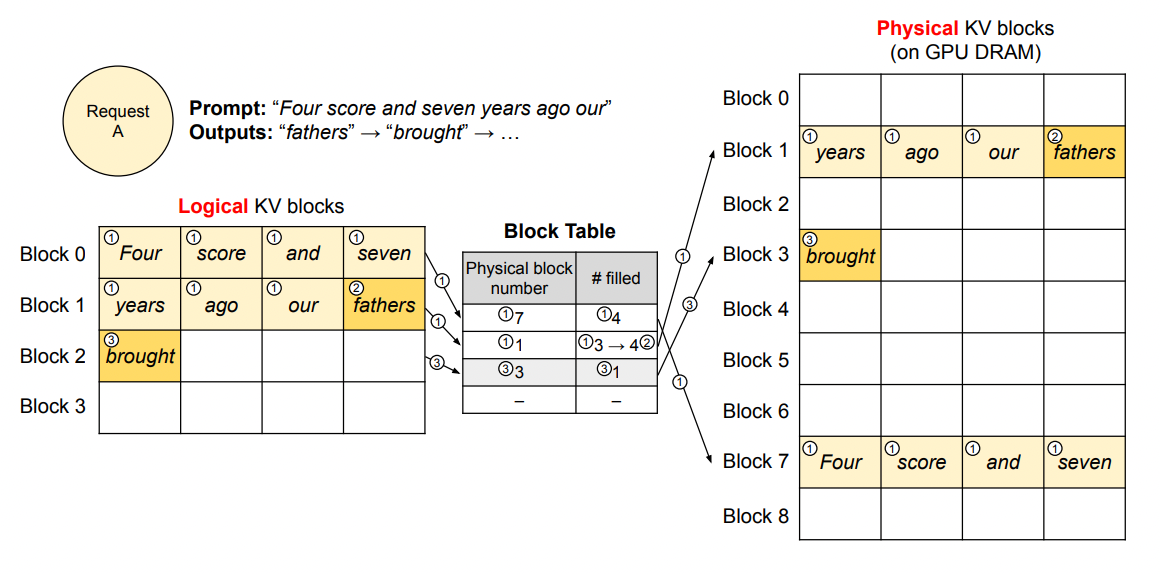 在图中:
- 请求(Request)可理解为操作系统中的一个进程
- 逻辑内存(Logical KV blocks)可理解为操作系统中的虚拟内存,每个 Block 类比于虚拟内存中的一个 Page。每个 Block 的大小是固定的,在 vLLM 中默认大小为 16,即可装 16 个 token 的 K/V 值(对应
CacheConfig.DEFAULT_BLOCK_SIZE = 16,见vllm/config/cache.py) - 块表(Block table)可理解为操作系统中的虚拟内存到物理内存的映射表
- 物理内存(physical KV blocks)可理解为操作系统中的物理内存,物理块在 GPU 显存上
带圈的序号表示操作步骤,按此顺序分析:
1. Prefill 阶段
划分逻辑块:vLLM 拿到这条 Prompt,先按照设定好的 Block 大小 B(本例中 B=4),为 Prompt 划分逻辑块(Logical KV blocks)。由于 Prompt 中有 7 个 token,所以 vLLM 用 2 个逻辑块(block 0,block 1)来装它们的 KV 值。其中,逻辑块 1 目前只装了 “years”、“ago”、“hour” 这 3 个 token 的 KV 值,有 1 个位置是空余的,这个位置被称为保留位(reservation)。
划分物理块:划分好逻辑块后,将其映射到物理块中。物理块是实际存放 KV 值的地方。通过 Block Table 来记录逻辑块和物理块的映射关系,Block Table 的主要内容包括:
- 逻辑块和物理块的映射关系(Physical block number):例如逻辑块 0 对应物理块 7
- 每个物理块上被填满的槽位(# filled):例如在 Prefill 阶段,物理块 7 的 4 个槽位都被填满;物理块 1 的 3 个槽位被填满
正常计算 Prompt 的 KV 值,并通过划分好的关系填入物理块中。
2. 生成第 1 个词
- 使用 KV Cache 计算 attention,生成第 1 个词 fathers。当计算时,使用的是逻辑块,即形式上这些 Token 都是连续的。与此同时,vLLM 后台会通过 Block Table 这个映射关系,从物理块上获取数据做实际计算。通过这种方式,每个 Request 都会认为自己在一个连续且充足的存储空间上操作,尽管物理上这些数据的存储并不连续。
- 基于新生成的词,更新逻辑块、物理块和 Block Table。对于 Block Table,vLLM 将 filled 字段由 3 更新至 4。
- 分配新的逻辑块和物理块。当 fathers 更新进去后,逻辑块已装满。因此 vLLM 将开辟新的逻辑块 2,并同时更新对应的 Block Table 和物理块。
3. Decode 阶段——生成第 2 个词
类比步骤(2)进行。
3.2.2初始化
在模型部署的初始化阶段(推理正式开始前),vLLM 需要确定 GPU/CPU 上可以分配多少个 KV Cache 物理块。
第一步:构造 Dummy 数据
用户在初始化引擎时,会涉及两个重要参数,一般来说会在启动参数中自定义:
max_num_seqs:在一个推理 Step 中,引擎最多能处理的 seq 数量(1 条 seq 就是 1 条待推理的数据)。max_num_batched_tokens:在一个推理 Step 中,引擎最多能处理的 token 数量。
根据这两个参数,可以假设在模型推理中,平均一个 seq 要处理 max_num_batched_tokens // max_num_seqs 个 token,余数部分默认放在第一个 seq 中。例如,假设 max_num_batched_tokens=10,max_num_seqs=3,那么就能构造出 3 条 seq,每个 seq 的长度分别为 4、3、3。
第二步:用 Dummy 数据模拟一次前向推理
目标是估算一次推理过程中,可以分配多少显存给 KV Cache。可以使用如下公式计算:
分配给 KV Cache 的显存 = GPU 可用显存 - 不使用 KV Cache 做一次推理时的显存占用(包括模型权重和推理过程中的中间数据)- CUDA Graph 内存估算
对于不使用 KV Cache 做一次推理时的显存占用,使用构造出的 Dummy 数据模拟一次前向推理来测量。
第三步:计算可分配的 KV Cache 物理块总数
从第二步的 profiling 中,已经预估了 分配给 KV Cache 的总显存。接下来计算总的物理块数量:
总物理块数量 = 分配给 KV Cache 的显存大小 / 所有层的物理块大小之和
物理块尺寸(Block Size),即一个物理块有多少个槽位,默认为 block_size = 16。单个物理块的字节大小按层计算,对于标准全量 Attention 层(FullAttentionSpec),单层的物理块字节数为:
per_layer_page_size = block_size * num_kv_heads * (head_size + head_size_v) * dtype_size
其中 dtype_size 表示精度对应的大小(例如 fp16 为 2,fp32 为 4),num_kv_heads 是 KV 头的数量(GQA 模型中小于 Query 头数)。对于大多数模型 head_size == head_size_v,公式等价于:
per_layer_page_size = block_size * num_kv_heads * head_size * dtype_size * 2
所有层的物理块大小之和即为:sum(per_layer_page_size for each layer)。当所有注意力层规格相同时,等价于 per_layer_page_size * num_layers。
知道了物理块的大小,就能求出物理块的总数。
CPU 上物理块总数也是同理,但与 GPU 不同的是,它不需要做 profiling。CPU 上可用的内存总数是用户通过参数传入的(默认 4 GiB)。将上面公式中 分配给 KV Cache 的显存大小 替换为 4 GiB,就能得到 CPU 上物理块的数量。
第四步:KV Cache GPU 预分配
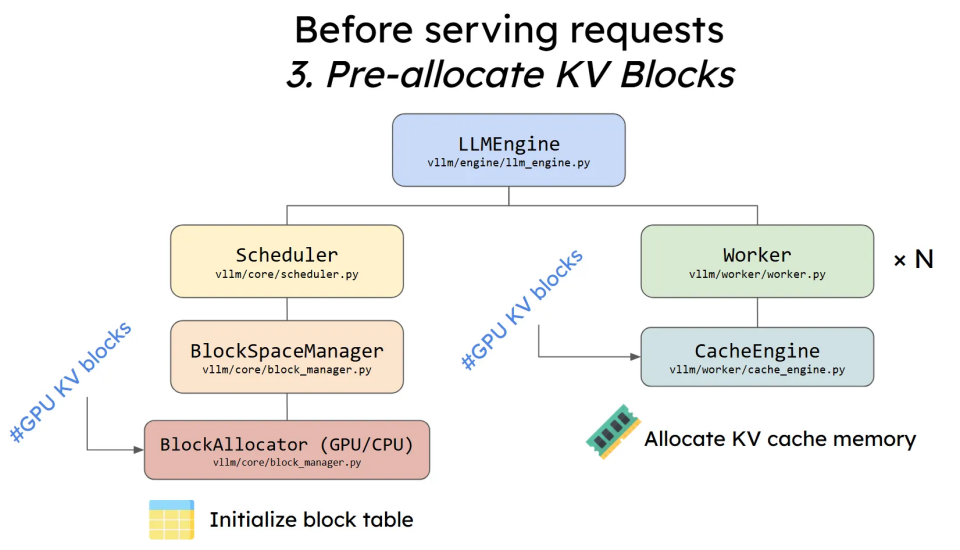 确定好 KV Cache Block 的数量后,创建 Empty Tensor 放置到 GPU 上,实现显存的预分配。这里涉及两种布局方式:跨层统一布局(适用于 KV Connector 传输优化场景)和常规布局。
3.2.3 跨层统一布局
vLLM 以 token 块为单位分配 GPU 内存,默认为每块 16 个 token。实际的物理布局取决于所使用的注意力后端(如 FlashAttention, FlashInfer 等)和所服务的模型。当今最常见的模型是统一(uniform)模型,由多层组成,每层都有自己的 KV 缓存,但形状相同。vLLM 也支持混合(hybrid)模型,目前尚未针对 Offloading Connector 进行优化。对于统一模型,vLLM 为每一层分配自己的 KV 缓存,因此单个逻辑块的 KV 缓存被分割成 num_layers 个块,每层一个。此外,根据注意力后端不同,每层块可能进一步分割为 2 个子块,一个用于 K(键缓存),一个用于 V(值缓存)。
这种碎片化对模型计算性能没有意义,但对 KV 卸载却是毁灭性的,因为它在 KV 缓存布局中产生了不必要的碎片,导致有效块大小变小。为了克服这个问题,PR https://github.com/vllm-project/vllm/pull/27743 做了优化,它创建了一个包含所有层 KV 数据的连续物理块。这一更改有效地将物理块大小增加了 2 * num_layers 倍,进而将 Offloading Connector 的吞吐量提高了一个数量级。
以 Flash Attention 为例说明 layout 变化
Flash Attention 默认 shape 为
(2, num_blocks, block_size, num_kv_heads, head_size)
在 allocate_uniform_kv_caches加入 num_layers 后,变为
(num_layers, 2, num_blocks, block_size, num_kv_heads, head_size)
    def get_kv_cache_shape(
        num_blocks: int,
        block_size: int,
        num_kv_heads: int,
        head_size: int,
        cache_dtype_str: str = "auto",
    ) -> tuple[int, ...]:
        if block_size % 16 != 0:
            raise ValueError("Block size must be a multiple of 16.")
        return (2, num_blocks, block_size, num_kv_heads, head_size)
Flash Attention 的 layout 区分两种情况:
- NHD (Normal, Heads, Depth):
num_blocks变化最快,适合某些访问模式 - HND (Heads, Normal, Depth):
num_kv_heads变化最快,有利于向量化
   def get_kv_cache_stride_order(
        include_num_layers_dimension: bool = False,
    ) -> tuple[int, ...]:
        # `stride_order` indicates the permutation that gets
        # us from `get_kv_cache_shape` to the actual memory layout we want.
        cache_layout = get_kv_cache_layout()
        if cache_layout == "NHD" and include_num_layers_dimension:
            # (num_blocks, num_layers, 2, block_size, num_kv_heads, head_size)
            return (2, 0, 1, 3, 4, 5)
        elif cache_layout == "NHD":
            stride_order = (0, 1, 2, 3, 4)
        elif cache_layout == "HND" and include_num_layers_dimension:
            # (num_blocks, num_kv_heads, num_layers, 2, block_size, head_size)
            return (2, 4, 0, 1, 3, 5)
        elif cache_layout == "HND":
            stride_order = (0, 1, 3, 2, 4)
        else:
            raise ValueError(f"Unknown cache layout format {cache_layout}.")
        return stride_order
NHD 场景
(num_layers, 2, num_blocks, block_size, num_kv_heads, head_size)
    0        1      2           3           4             5

                            |
                          转化为
                            |

    2            0       1      3             4           5
(num_blocks, num_layers, 2, block_size, num_kv_heads, head_size)
NHD 转化后的布局,可以通过 Block 获取 Block KV Cache 所有层的连续地址空间
HND 场景
(num_layers, 2, num_blocks, block_size, num_kv_heads, head_size)
    0        1      2           3           4             5

                            |
                          转化为
                            |

    2            4            0        1       3          5
(num_blocks, num_kv_heads, num_layers, 2, block_size, head_size)
HND 转化后的布局,可以通过 Block 获取 Block KV Cache 的同一个 head 的所有层,适合按 head 批量访问
修改后的 layerout Block 大小对比
| 模型 | 旧块大小 | 新块大小 |
|---|---|---|
| deepseek-ai/DeepSeek-R1-Distill-Qwen-32B (TP=2) | 16 KB | 2 MB |
| deepseek-ai/DeepSeek-V2-Lite-Chat (GPU block size=64) | 72 KB | 1.9 MB |
| meta-llama/Llama-3.1-8B-Instruct | 32 KB | 2 MB |
| meta-llama/Llama-3.2-1B-Instruct | 16 KB | 0.5 MB |
| meta-llama/Llama-3.1-70B-Instruct | 8 KB | 1.25 MB |
| mistralai/Mistral-7B-Instruct-v0.2 | 32 KB | 2 MB |
| mistralai/Mistral-Small-24B-Instruct-2501 | 32 KB | 2.5 MB |
| Qwen/Qwen2.5-3B-Instruct | 8 KB | 0.56 MB |
| Qwen/Qwen3-0.6B | 32 KB | 1.75 MB |
| Qwen/Qwen2.5-7B-Instruct | 16 KB | 0.87 MB |
| Qwen/Qwen3-4B-Instruct-2507 | 32 KB | 2.25 MB |
| Qwen/Qwen2.5-1.5B-Instruct | 8 KB | 0.44 MB |
| Qwen/Qwen3-8B | 28 KB | 1.97 MB |
| Qwen/Qwen3-1.7B | 32 KB | 1.75 MB |
| Qwen/Qwen3-32B (TP=2) | 16 KB | 2 MB |
3.2.4 Block 管理机制
初始化阶段完成了 KV Cache GPU Tensor 的预分配,但对于每次推理,还需要一套逻辑层的管理机制来决定"哪个请求使用哪些物理块"。这套机制完全运行在调度器侧(CPU),主要由以下核心组件构成:
KVCacheManager                   <- 顶层入口,对接 Scheduler
  +-- KVCacheCoordinator           <- 多 KV Cache Group 协调
       +-- SingleTypeKVCacheManager <- 单类型 block 分配(每个 group 一个)
            +-- BlockPool           <- 物理块池,管理 KVCacheBlock
                 +-- FreeKVCacheBlockQueue  <- LRU 双向链表
KVCacheSpec 类型体系
KVCacheSpec是描述"某一层 KV Cache 格式"的数据结构。不同模型架构对应不同子类:
| 类名 | 适用场景 |
|---|---|
AttentionSpec | Attention 类型的通用基类,定义了 num_kv_heads、head_size、dtype 等公共属性 |
FullAttentionSpec | 标准全量 Attention(含 GQA),最常见的类型,支持 head_size_v 可与 head_size 不同 |
MLAAttentionSpec | MLA(Multi-head Latent Attention),如 DeepSeek-V3,K/V 合并为单个 latent 向量 |
SlidingWindowSpec | 滑动窗口 Attention |
ChunkedLocalAttentionSpec | Chunked Local Attention |
SinkFullAttentionSpec | Sink + Full Attention(Attention Sink 优化) |
EncoderOnlyAttentionSpec | 仅 Encoder 的 Attention |
CrossAttentionSpec | Encoder-Decoder 跨注意力 |
MambaSpec | Mamba SSM 状态缓存(非 Attention 架构) |
UniformTypeKVCacheSpecs | 跨层统一规格的聚合 Spec,用于 KV Connector 优化 |
其中最重要的属性是 page_size_bytes,计算单个物理块的字节数。以 FullAttentionSpec 为例:
@property
def real_page_size_bytes(self) -> int:
    return (
        self.block_size
        * self.num_kv_heads
        * (self.head_size + self.head_size_v)  # K + V
        * get_dtype_size(self.dtype)
    )
对于大多数模型 head_size == head_size_v,公式等价于 block_size * num_kv_heads * head_size * dtype_size * 2,与初始化章节中的公式一致。
KVCacheBlock 数据结构
每个物理块在调度器侧以 KVCacheBlock(vllm/v1/core/kv_cache_utils.py)对象表示,它只包含管理元数据,不持有实际的 KV 数据(KV 数据在 GPU Tensor 中):
@dataclass(slots=True)
class KVCacheBlock:
    block_id: int          # 物理块编号,范围 [0, num_gpu_blocks)
    ref_cnt: int = 0       # 引用计数
    _block_hash: BlockHashWithGroupId | None = None  # 块哈希(仅满块才有值)
    prev_free_block: "KVCacheBlock | None" = None    # 双向链表前驱
    next_free_block: "KVCacheBlock | None" = None    # 双向链表后继
    is_null: bool = False  # 是否为占位 null block
几个关键语义:
ref_cnt:ref_cnt > 0表示块正被至少一个请求使用;ref_cnt == 0表示块处于空闲状态,可被重新分配或驱逐_block_hash:仅当块被完全填满且启用 Prefix Caching 时才赋值。赋值后不可修改,只能通过reset_hash()在驱逐时清除is_null:null block是block_id=0的特殊占位块,用于滑动窗口等稀疏 Attention 中不需要实际缓存的位置,其ref_cnt不受正常管理约束
BlockPool
BlockPool是管理所有物理块的核心组件,负责块的分配、释放和 Prefix Caching 查找。初始化时创建 num_gpu_blocks 个 KVCacheBlock 对象,组织成 FreeKVCacheBlockQueue:
class BlockPool:
    def __init__(self, num_gpu_blocks, enable_caching, hash_block_size, ...):
        self.blocks = [KVCacheBlock(idx) for idx in range(num_gpu_blocks)]
        self.free_block_queue = FreeKVCacheBlockQueue(self.blocks)
        # block_id=0 的 null block 永远不参与正常分配
        self.null_block = self.free_block_queue.popleft()
        self.null_block.is_null = True
        # Prefix Cache 哈希表:block_hash -> KVCacheBlock
        self.cached_block_hash_to_block = BlockHashToBlockMap()
分配:get_new_blocks(num_blocks)
从 free_block_queue 头部(LRU 最久未使用端)弹出指定数量的块。若启用 caching 且块携带旧哈希,则驱逐出 prefix cache:
def get_new_blocks(self, num_blocks: int) -> list[KVCacheBlock]:
    if num_blocks > self.get_num_free_blocks():
        raise ValueError(...)
    ret = self.free_block_queue.popleft_n(num_blocks)
    if self.enable_caching:
        for block in ret:
            self._maybe_evict_cached_block(block)  # 清除旧哈希(若有)
            block.ref_cnt += 1
    else:
        for block in ret:
            block.ref_cnt += 1
    return ret
释放:free_blocks(ordered_blocks)
递减每个块的 ref_cnt,将降为 0 的块追加到队列尾部(成为 LRU 最新的驱逐候选):
def free_blocks(self, ordered_blocks):
    blocks_list = list(ordered_blocks)
    for block in blocks_list:
        block.ref_cnt -= 1
    self.free_block_queue.append_n(
        [b for b in blocks_list if b.ref_cnt == 0 and not b.is_null]
    )
引用(touch):touch(blocks)
当新请求命中某个 prefix cache 块时,将其 ref_cnt 加一,并从空闲队列中摘除,防止被驱逐:
def touch(self, blocks):
    for block in blocks:
        if block.ref_cnt == 0 and not block.is_null:
            self.free_block_queue.remove(block)  # O(1) 中间摘除
        block.ref_cnt += 1
FreeKVCacheBlockQueue(LRU 双向链表)
FreeKVCacheBlockQueue(vllm/v1/core/kv_cache_utils.py)是一个专为 KV Cache 设计的双向链表
[fake_head] <-> [block_3] <-> [block_7] <-> [block_1] <-> ... <-> [fake_tail]
  LRU 最久 <------------------------------------------------> 最近使用
  popleft() 从此端分配                        append() 释放后追加到此端
| 操作 | 方法 | 复杂度 | 说明 |
|---|---|---|---|
| 分配 | popleft_n(n) | O(n) | 从链表头弹出,驱逐最旧块 |
| 释放 | append_n(blocks) | O(n) | 追加到链表尾 |
| touch | remove(block) | O(1) | 从链表中间摘除 |
Prefix Caching(自动前缀缓存)
Prefix Caching(也称 APC,Automatic Prefix Caching)是 vLLM v1 的重要优化:对具有相同前缀的请求,复用已有的 KV Cache 块,跳过对应 token 的重复计算。
Block 哈希的链式计算
每个已填满的块的哈希以链式方式计算(vllm/v1/core/kv_cache_utils.py:hash_block_tokens),保证相同 token 序列得到相同哈希:
def hash_block_tokens(
    hash_function,
    parent_block_hash: BlockHash | None,  # 前一个块的哈希(链式依赖)
    curr_block_token_ids: Sequence[int],
    extra_keys: tuple | None = None,      # 多模态/LoRA/cache_salt 等额外键
) -> BlockHash:
    if not parent_block_hash:
        parent_block_hash = NONE_HASH     # 第一块使用固定种子
    return BlockHash(
        hash_function((parent_block_hash, tuple(curr_block_token_ids), extra_keys))
    )
通过链式哈希,block N 的哈希隐式包含了 block 0 到 block N-1 的所有 token 信息。因此两个块哈希值相同,当且仅当它们在序列中位置相同且所有前缀 token 完全一致。
对于包含多模态输入、LoRA 或用户指定 cache_salt 的请求,extra_keys 会将这些信息纳入哈希计算,防止不同类型请求的块错误命中。
完整流程
新请求到来
    |
    +-- get_computed_blocks()        查询 prefix cache,返回命中的块列表
    |       +-- BlockPool.get_cached_block()  按哈希查 cached_block_hash_to_block
    |
    +-- BlockPool.touch(命中的块)    ref_cnt++,从 free_block_queue 中摘除(保护)
    |
    +-- allocate_slots()             分配剩余所需的新块
    |       +-- BlockPool.get_new_blocks()
    |
    |  ... 推理执行,KV 数据写入 GPU Tensor ...
    |
    +-- cache_full_blocks()          每当一个块被填满,注册哈希到 prefix cache
    |       +-- hash_block_tokens()  计算链式哈希
    |       +-- cached_block_hash_to_block.insert()
    |
    +-- 请求完成 -> free_blocks()     ref_cnt--,块进入 free_block_queue 尾部
                                    (保留哈希,可被后续请求命中;空闲不足时才驱逐)
当空闲块不足需要分配新块时,从 free_block_queue 头部取出最旧的块。若该块仍带有哈希(即它是一个"被释放但尚未驱逐"的 prefix cache 块),则调用 _maybe_evict_cached_block() 将其从哈希表中移除并清除哈希,然后重新分配给新请求。
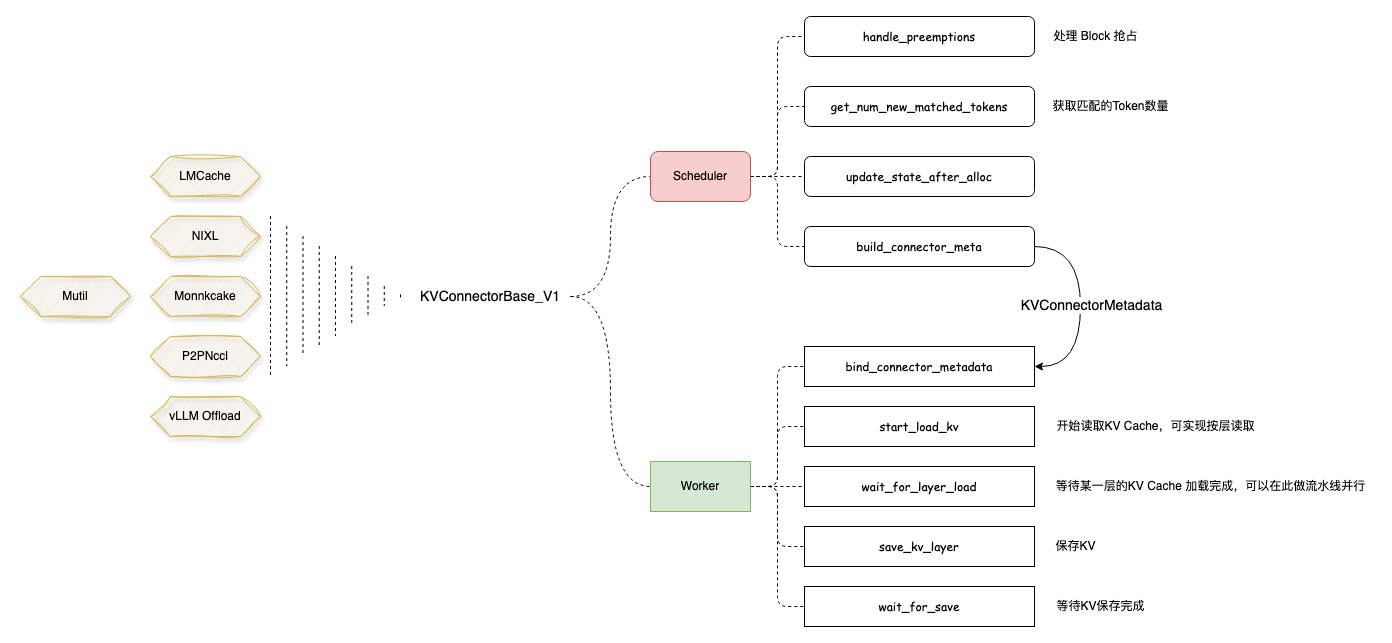
3.2.5KV Connector
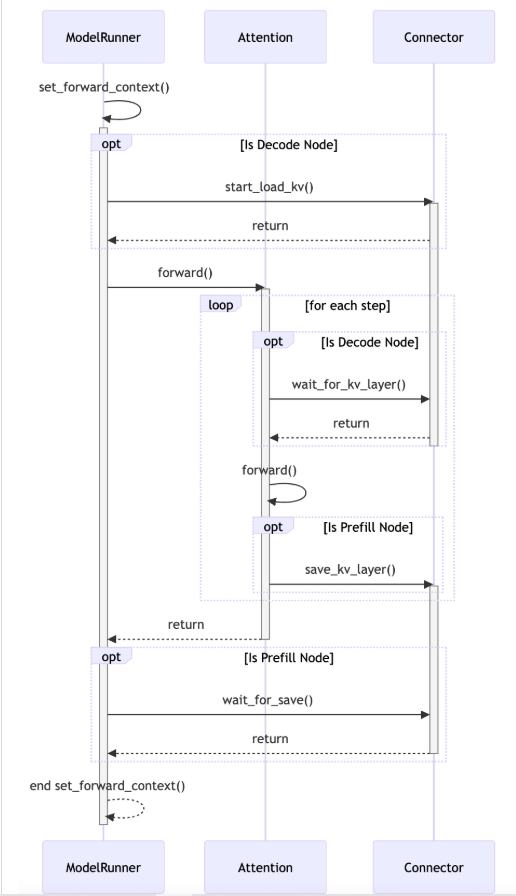
vLLM 提供了 KV Connector 作为管理实例间 KV Cache 交换的抽象层,它提供统一接口来实现 KV Cache 的保存、加载与传输,使不同的 vLLM 实例(如 Prefill 与 Decode 实例)能够高效共享计算结果。通过实现这一接口,各类 Connector 可以提供适合各自场景需求的 KV Cache 管理方案,从而支持 PD 分离、KV Cache Offload 等高级功能。
KV Connector 基类接口与其实现
调用链
4.KV Cache 厂内工程落地——AttentionStore
4.1.AttentionStore简介
KV Cache 是大模型自注意力机制在推理时缓存的中间结果,Prefix Cache 复用、Prefill / Decode 分离等优化都依赖对 KV Cache 的管理能力, AttentionStore 项目就是在此背景上出现的 KV Cache 多级缓存项目,其理论基础可以参考论文 Cost-Efficient Large Language Model Serving for Multi-turn Conversations with CachedAttention 和其解读 CachedAttention论文解读
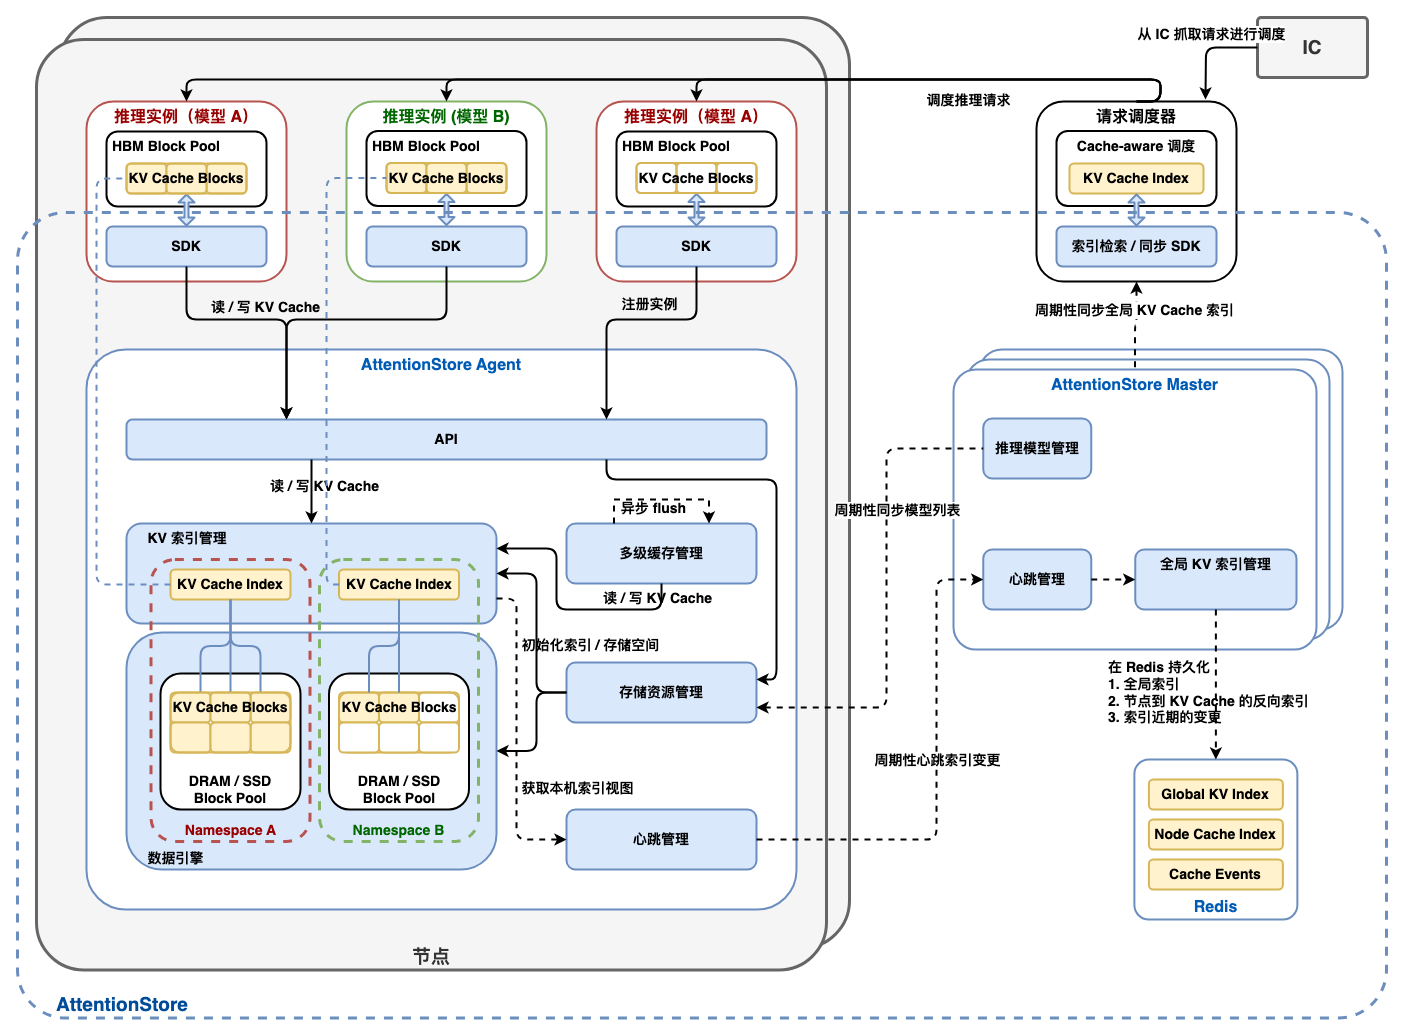 为了解决显存无法容纳长上下文业务场景所需存放的 KV Cache 问题,业内普遍采用了 KV Cache Offload 方案 —— 它提供了一种兼具性能与成本效益的技术路径:将历史 KV Cache 从昂贵的显存中迁移至更具性价比的存储介质(如内存、SSD 等),在会话延续时按需加载实现数据复用。然而,在将这一方案大规模落地到生产业务过程中,还需要解决三个关键问题:
- 调度系统要如何匹配到最优节点,避免昂贵的重复计算开销:传统调度系统无法感知缓存的全景分布与介质状态,存在严重的调度盲区。这导致请求往往被分发至无缓存节点,触发大规模重复计算与存储冗余,难以发挥分布式缓存的集群效应;
- 如何提升多级缓存间的数据搬运效率,加快响应速度:传统方案难以针对异构芯片的底层访存特性进行深度优化,在多级存储介质(HBM - DRAM - SSD)之间搬运动态数据时,数据通路效率低下,极易引入额外的传输时延,抵消掉复用缓存带来的性能增益;
- 会话中断后,如何避免 KV Cache 丢失:传统方案中,缓存管理与推理进程强耦合:一旦推理引擎进程退出或异常重启,缓存数据即刻失效。
4.2.AttentionStore —— KV Cache 全局调度与高效流转系统
正是由于上述问题的存在,KV Cache Offload 并不能仅停留在「存储迁移」层面,而必须在调度、数据通路与缓存管理机制上进行系统性升级。
在这一背景下,百度百舸构建了 KV Cache 分布式缓存管理体系 AttentionStore,并基于昆仑芯硬件平台进行了深度适配与调优。
AttentionStore 通过在推理集群层面实现多维感知与精准调度,以及在执行节点中加快缓存数据的传输效率,AttentionStore 可实现高达 80% ~ 90% 的 KV Cache 缓存命中率,大幅降低推理成本;并系统性减少重复 Prefill 计算开销,显著降低 TTFT。
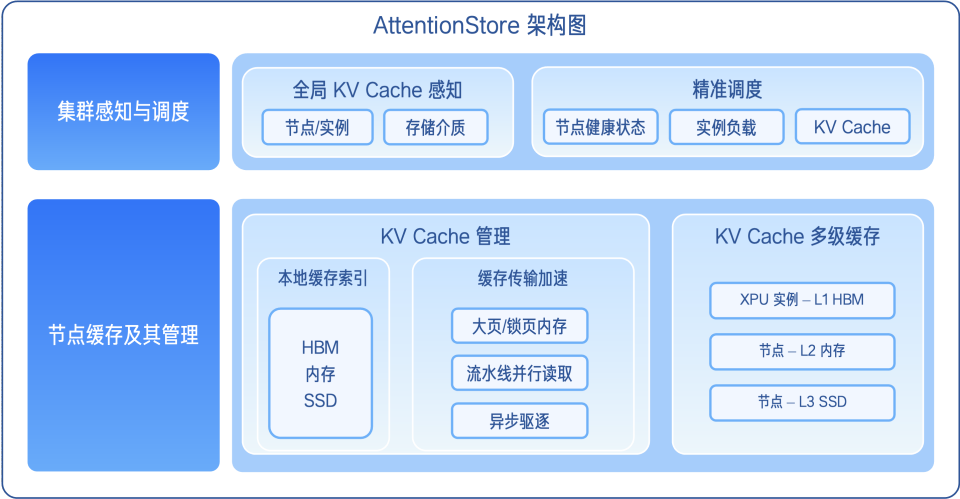 为了保障 KV Cache 服务连续性,我们将 AttentionStore 与推理引擎解耦,以独立进程的形式运行在每个推理节点上,当推理进程重启、故障恢复或版本升级时,KV Cache 依旧可以稳定保存在 AttentionStore 管理的存储空间中,可在后续推理中重新加载使用。同时,AttentionStore 采用共享内存和 SSD 作为主机缓存介质,其自身重启后可通过本地索引表快速实现数据恢复,实现服务升级与维护期间业务无感切换。
4.3.KV Cache 全局感知,优化推理调度决策链
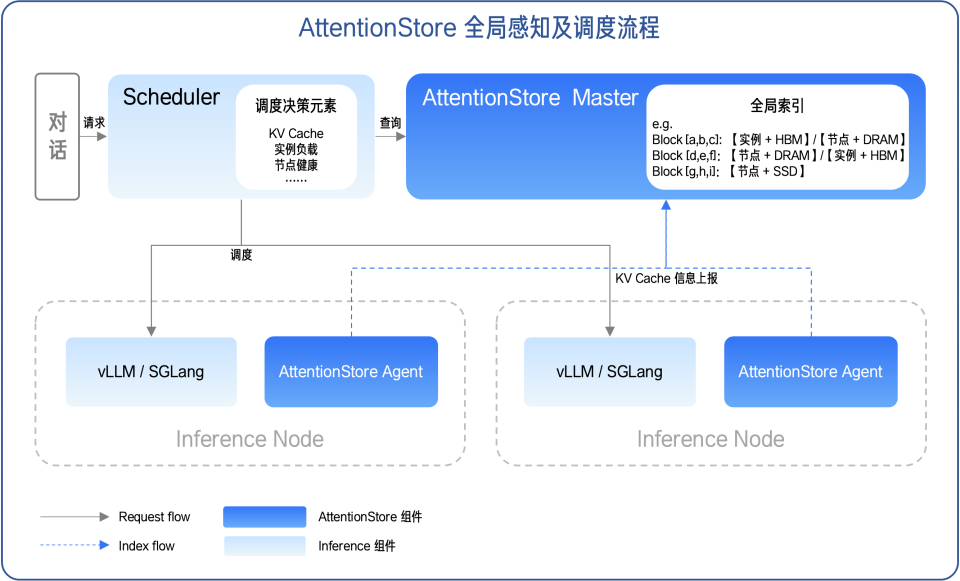
在实际生产环境中,推理请求往往运行在多节点、多实例的分布式架构之上。若推理调度器对缓存分布无感知,仅依据不同实例的状态及负载等因素进行调度决策,极易出现「请求被调度至无缓存节点」的情况,从而触发完整的 Prefill 重算,使得 Offload 带来的性能收益被完全抵消。
为此,凭借行业领先的 KV Cache 多维感知,我们在推理集群内构建了实时 KV Cache 全局索引视图;并将 KV Cache 纳入调度决策,使调度从「只看资源」升级为「资源与缓存协同决策」。
- 全局 KV Cache 索引:我们在全局层面汇聚了各推理节点的 KV Block 信息,包括 BlockHash、所在存储介质(HBM / DRAM / SSD)等元数据,并实时捕捉 KV Cache 的创建与销毁事件,从而精准掌握最新的全局 KV Cache 索引,形成 Host → Blocks 映射关系;
- 调度决策优化:在具备全局感知能力之后,KV Cache 的命中情况被正式纳入调度决策路径。在原有基于负载与健康状态筛选候选节点的基础上,调度器会根据请求上下文,将调度目标先收敛到具备高缓存命中率的节点集合,并结合命中长度以及缓存所在存储介质(HBM / DRAM / SSD)的读取效率,对候选节点进行综合打分。
最终,推理集群调度不再仅以「是否可用」为标准,而是以「是否最优」为目标——将请求优先分配至缓存命中率更高、数据加载速度更快的节点,在保障负载均衡的前提下,最大化 KV Cache 复用价值,系统性降低重复 Prefill 开销,并显著优化 TTFT 表现。
4.4.KV Cache 多级缓存优化,加速数据传输效率
实现 KV Cache 的全局感知与精准调度,解决了长上下文推理中缓存「调度匹配」的核心问题;而在多级缓存体系中,跨介质的数据传输效率与多数据传输的并行能力,是决定 KV Cache 复用性能的另一关键因素。为此,我们通过 AttentionStore 对 KV Cache 的全生命周期数据通路进行了深度优化,构建了高效的多级缓存体系,实现跨介质数据传输的全面加速。
在典型的长文本推理场景下,KV Cache 在 HBM、DRAM、SSD 多级缓存体系中的数据流转遵循以下逻辑:
- 请求到达时,Prefill 节点优先尝试从显存 KV Cache 中匹配;
- 若显存未命中,将借助节点间的 KV Cache 池化能力快速将缓存数据迁移至目标 Prefill 节点的主机内存;仍未命中的部分则由 Prefill 节点即时计算生成;
- Prefill 节点生成的 KV 传输至 Decode 节点,并异步回写至主机内存 / SSD;
- Decode 节点在推理过程中新生成的 KV 增量,异步回写至 Prefill 节点的主机内存 / SSD。
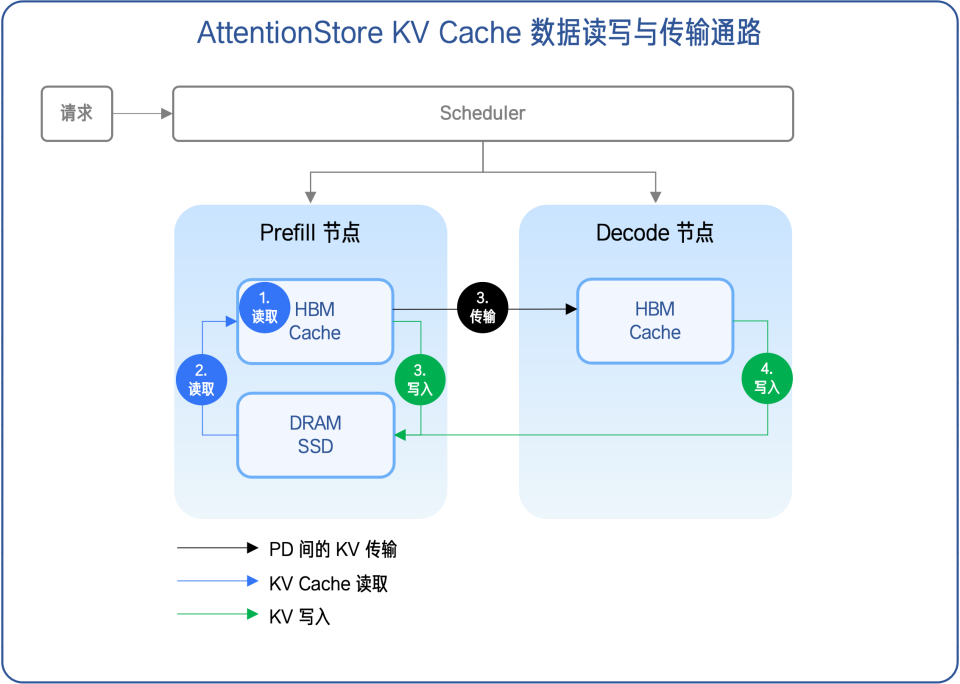
针对上述链路中的读取、写入及传输环节,我们实施了如下针对性优化:
- 昆仑芯底层原生适配:面向昆仑芯 XPU 架构,我们进行了 AttentionStore 方案的深度适配—— 针对 KV Cache 在显存、内存与 SSD 之间高频流转的特征,通过调用 XPU 原生 API,对数据搬运、缓存访问及执行调度等关键路径进行专项优化,从而充分发挥昆仑芯在带宽与访存效率上的硬件能力。同时,借助统一的硬件抽象与适配层,确保了底层指令集的无缝切换,由此,上层业务无需关注具体运行在何种硬件架构之上,即可获得一致的缓存复用能力与性能表现,实现了跨硬件环境的平滑运行;
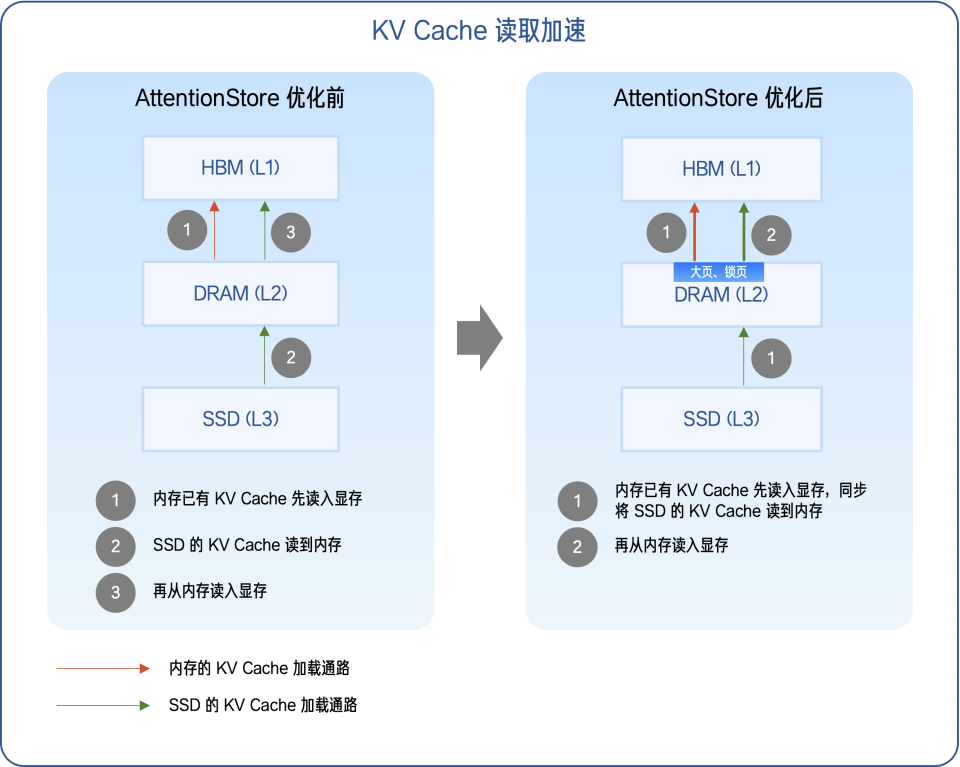
- KV Cache 读取加速:在 HBM、DRAM 与 SSD 混合命中的场景下,传统的 KV Cache 读取采用串行逻辑(如下图左侧「AttentionStore 优化前」所示),这种方式的读取耗时较长。对此,我们通过将 KV Cache 的读取过程拆分为并行任务 —— 让高速介质与低速介质同步发起传输(如下图右侧「AttentionStore 优化后」所示),最大程度缩短全部 KV Cache 的读取耗时。此外,我们将 AttentionStore 管理的共享内存标记为大页内存,显著减少页表项数量,降低地址转换开销,提高内存访问效率;同时,通过全生命周期锁页操作,避免 KV Cache 数据在传输过程中被换出,减少额外的内存拷贝与页错误开销,使数据能够以更稳定、更高带宽的方式直达显存。实测显示,DRAM 到 HBM 的通信效率较基线提升了 4 倍,让 DRAM 与 SSD 中的缓存数据能够更快进入显存参与计算;
- KV 传输加速:为了提高 KV 在 Prefill-Decode 节点间的传输效率,我们首先在推理引擎之外,引入基于 C++ SDK 的高性能数据通路,对 KV Cache 的传输过程进行独立管理与优化。具体而言,通过 C++ SDK 扩展,我们将 KV 数据的序列化、打包与跨节点传输等操作从推理主进程中解耦出来,并交由独立的异步线程池负责执行,使 KV 传输与模型计算形成并行流水线,避免二者的相互阻塞。其次,在数据流传路径上,我们进一步对 KV 的回写与 P、D节点间传输流程进行了重构:传统模式下,P 节点会先将 KV Cache 完整回写至内存 / SSD,再将其传输至 D 节点;在 AttentionStore 中,我们将这一过程拆分为多个细粒度任务,通过异步机制实现「写回与传输同步进行」。借此,在保障推理任务连续执行的同时,显著提升 KV Cache 的跨节点传输效率。
4.5.实践效果:超长上下文场景下的性能飞跃
在 PD 分离推理架构中,我们基于 DeepSeek R1 671B 模型,在昆仑芯 P800 集群环境中对 AttentionStore 的 KV Cache Offload 方案进行了系统验证。
环境及配置:
- 2 台 Prefill 节点,TP4 / DP4 并行配置
验证效果:
- 当上下文长度达到 8K 以上时,AttentionStore 的 TTFT 指标具有 50%~80% 的稳定优化收益;
- 多轮对话场景中,通过避免重复 Prefill 并提升 Prefill 节点的可复用性,系统整体吞吐量提升了 5.4 倍;
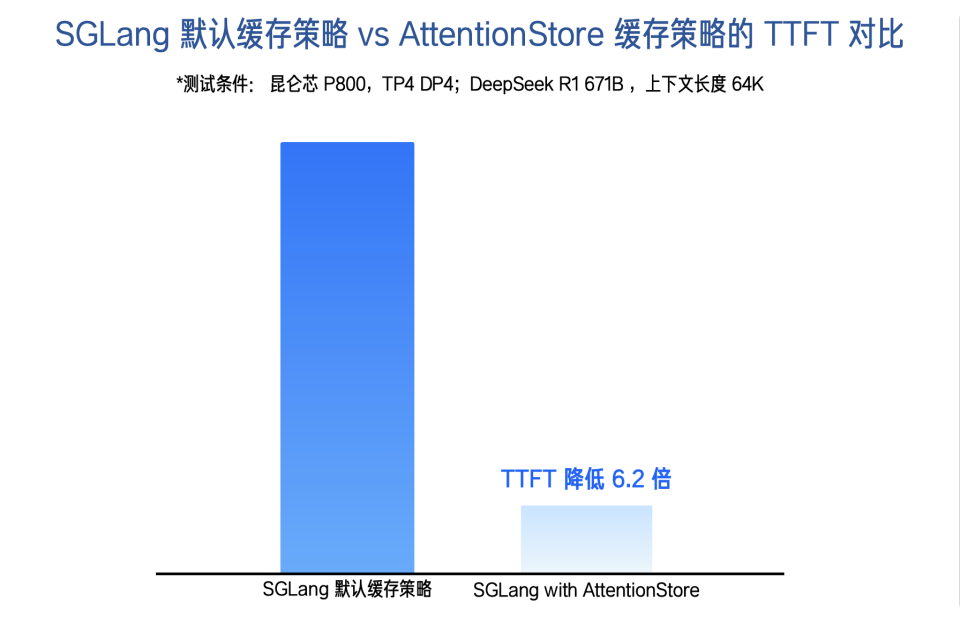
- 在 64K 长上下文场景中,相较于推理引擎默认 Chunk-Prefill 缓存策略,基于 AttentionStore 的 KV Cache Offload 方案显著减少了历史上下文的 Prefill 重算开销,使 TTFT(首 Token 时延)降低 6.2 倍;
具体详情可见文章 拒绝 OpenClaw 成为「吞金龙虾」,百度百舸打造极致 KV Cache 调度与加速引擎
5.附录
- A Survey on Efficient Inference for Large Language Models
- YOCO You Only Cache Once: Decoder-Decoder Architectures for Language Models
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints
- H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models
- SnapKV: LLM Knows What You are Looking for Before Generation
- https://github.com/LMCache/LMCache/
- https://github.com/vllm-project/aibrix
- Layerkv: Optimizing large language model serving with layer-wise kv cache management
- Cost-efficient large language model serving for multi-turn conversations with cachedattention
- Alisa: Accelerating large language model inference via sparsity-aware kv caching,
- Fast inference for augmented large language models
- 拒绝 OpenClaw 成为「吞金龙虾」,百度百舸打造极致 KV Cache 调度与加速引擎
- https://zhuanlan.zhihu.com/p/698308542