@home$
Systems, code, and things worth understanding.
很惭愧,就做了一点微小的工作。
Contributed to some open source projects, including:
go-mysql-driver/mysql gogf/gf fastclaw-ai/weclaw tw93/Kaku
Worked on some company projects, including:
incident.woa.com mdb.woa.com dbmanager.woa.com/api dba.baidu.com/mis
tRPC-Go 与 RPC 基础
tRPC-go
先说一说RPC
remote procedure call protocol 远程调用协议
客户端在不知道调用细节的情况下,调用存在于远程计算机上的某个对象,就像调用本地应用程序中的对象一样。
C/S 架构
当客户端发送的请求消息到达服务器时,服务器上的操作系统就将他传递给服务器存根(server stub), 服务器存根是客户存根在服务器端的对应程序和真正实现,用来将通过网络输入的请求转化为本地过程调用 服务器存根一直在等待客户端的调用,处于阻塞状态,等待消息输入。
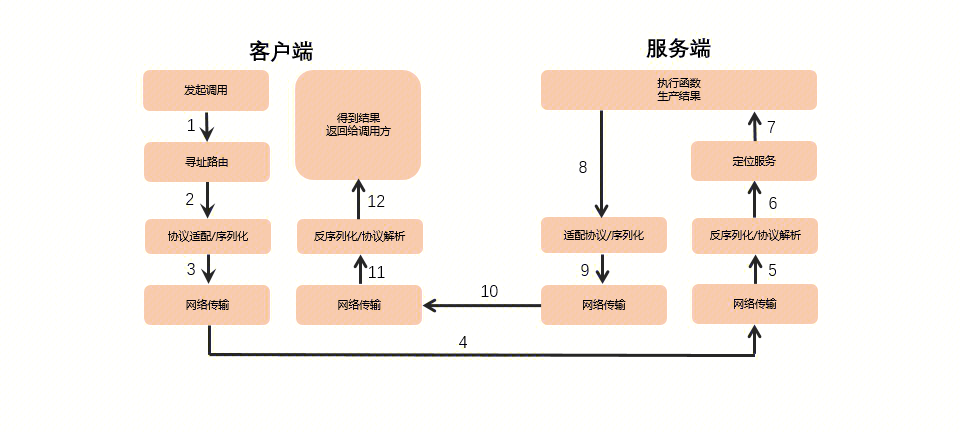
RPC流程
客户端进程以正常方式调用客户存根
客户存根生成一个消息。然后调用本地操作系统的网络通信模块,存根进入阻塞状态。
客户端操作系统将网络消息发送给远程操作系统。
远程操作系统将网络消息交给服务器存根。
服务器存根从网络消息将参数提取出来,而后调用服务器存根。
服务器执行相应的程序,操作完成后将结果返回给服务器存根。
服务器存根打包消息,调用本地操作系统。
发送给客户端操作系统。
客户端操作系统将消息交给客户端存根,存根从阻塞状态回复,进入运行状态。
客户端存根从消息中提取结果,返回调用的客户端。
过程中需要考虑的问题:
- 参数传递
- 通信协议
- 出错
- 超时处理
一些说明
- 既然是协议就只是一套规范。那么就需要有人遵循这套规范来进行实现 典型的RPC协议 Dubbo Thrift gRPC Hetty
- 网络协议和网络io模型 对其透明 既然RPC的客户端认为自己是在调用本地对象。那么传输层使用的是TCP/UDP还是HTTP协议,又或者是一些其他的网络协议它就不需要关心了。
- 信息格式对其透明.
- 应该有跨语言能力, 调用方也不清楚远程服务器的应用程序是使用的什么语言与你性的,对于调用方来说,无论服务器方使用的什么语言,本次调用都应该成功。并且放回置应该按照调用方程序语言所能理解的形式表达。
IDL interface definition language
protocol buffer language .proto version 3
syntax = "proto3"   // 必须
message SearchRequest{
  string query = 1;
  int32 page_number = 2;
  int32 result_per_page = 3;
}
tRPC 能做什么
- 搭建多个端口支持多个协议(一个端口对应一个协议)
- 搭建消息队列消费者服务 提供消息队列生产者客户端发送消息
- 搭建本地定时器 分布式定时器服务
- 搭建流式服务 实现push 文件上传 消息下发等流式模型
- 访问各种私有协议后端服务
- 通过trpc工具生成桩代码和服务模板
需要基础知识
- Go语言基础
- context原理
- RPC概念
- tRPC术语
- proto3知识
安装 proto
…Go database/sql 连接池源码阅读
Golang database/sql 数据库连接源码阅读
代码仓库 database/sql
打开数据库连接方法
打开数据库连接 sql.Open() 返回 *sql.DB
// Open 打开一个由数据库驱动名称和驱动特定的数据源名称指定的数据库,
// 通常至少包括一个数据库名称和连接信息。
//
// 大多数用户会通过一个特定于驱动的连接助手函数来打开数据库,该函数返回一个 [*DB]。
// Go 标准库中不包含数据库驱动。请参见 <https://golang.org/s/sqldrivers> 获取第三方驱动列表。
//
// Open 可能仅验证其参数而不创建数据库连接。要验证数据源名称是否有效,请调用 [DB.Ping]。
//
// 返回的 [DB] 对象是线程安全的,可以被多个 goroutine 并发使用,并维护自己的空闲连接池。
// 因此,Open 函数通常只需调用一次。通常不需要关闭 [DB]。
func Open(driverName, dataSourceName string) (*DB, error) {
	driversMu.RLock()
	driveri, ok := drivers[driverName]
	driversMu.RUnlock()
	if !ok {
		return nil, fmt.Errorf("sql: unknown driver %q (forgotten import?)", driverName)
	}

	if driverCtx, ok := driveri.(driver.DriverContext); ok {
		connector, err := driverCtx.OpenConnector(dataSourceName)
		if err != nil {
			return nil, err
		}
		return OpenDB(connector), nil
	}

	return OpenDB(dsnConnector{dsn: dataSourceName, driver: driveri}), nil
}
先看一下DB 定义
…分布式数据库与云原生数据库的区别
分布式数据库和云原生数据库有一定的关联,但二者的关注点和设计理念不同。可以从 概念、关系、区别 三个角度来看:
1. 概念
1.1 分布式数据库
定义:数据库的数据和计算分布在多台服务器上,通过网络协同工作,对用户透明地提供统一访问接口。
核心目标:
数据分片和多副本存储(高可用)。
支持水平扩展(scale-out)。
提供分布式事务和全局一致性。
典型产品:TiDB、CockroachDB、OceanBase、MongoDB、Cassandra。
1.2 云原生数据库
定义:基于云原生架构理念(容器化、微服务、弹性伸缩、可观测性)设计的数据库。
核心特性:
原生支持云平台:容器化、Kubernetes 管理。
计算与存储分离,支持弹性扩缩容。
按需计费、自动运维、快速恢复。
深度利用云基础设施(分布式存储、Serverless)。
典型产品:Aurora、PolarDB、TiDB Cloud、YugabyteDB、Spanner。
2. 关系
云原生数据库通常是分布式数据库的延伸
- 云原生数据库的底层架构往往是分布式数据库(支持水平扩展、多副本)。
不是所有分布式数据库都是云原生数据库
- 传统分布式数据库如果未支持容器化、自动弹性、计算存储分离,就不算云原生。
简单理解:
分布式数据库 = 架构形态
云原生数据库 = 架构形态 + 云原生理念 + 云平台友好
3. 区别
| 维度 | 分布式数据库 | 云原生数据库 |
|---|---|---|
| 核心关注点 | 数据分布、水平扩展、一致性 | 云环境下弹性伸缩、自动化运维、资源高效利用 |
| 计算存储架构 | 多数是计算存储一体化或弱分离 | 倾向于计算存储彻底分离 |
| 运行环境 | 自建机房或云上虚拟机 | 云原生基础设施(K8s、分布式存储、Serverless) |
| 运维模式 | 运维成本高,需要人工或脚本管理 | 自动运维、监控、故障自愈 |
| 弹性能力 | 水平扩展需要手动加节点、数据迁移 | 支持分钟级或秒级弹性伸缩 |
4. 总结
分布式数据库是技术架构,云原生数据库是架构+理念的结合。
云原生数据库几乎都具备分布式特性,但在自动化、弹性、资源管理方面更先进。
如果说 分布式数据库解决“规模化、可用性”,那么 云原生数据库解决“云环境下弹性、自动化、降本增效”。
块存储、文件存储与对象存储
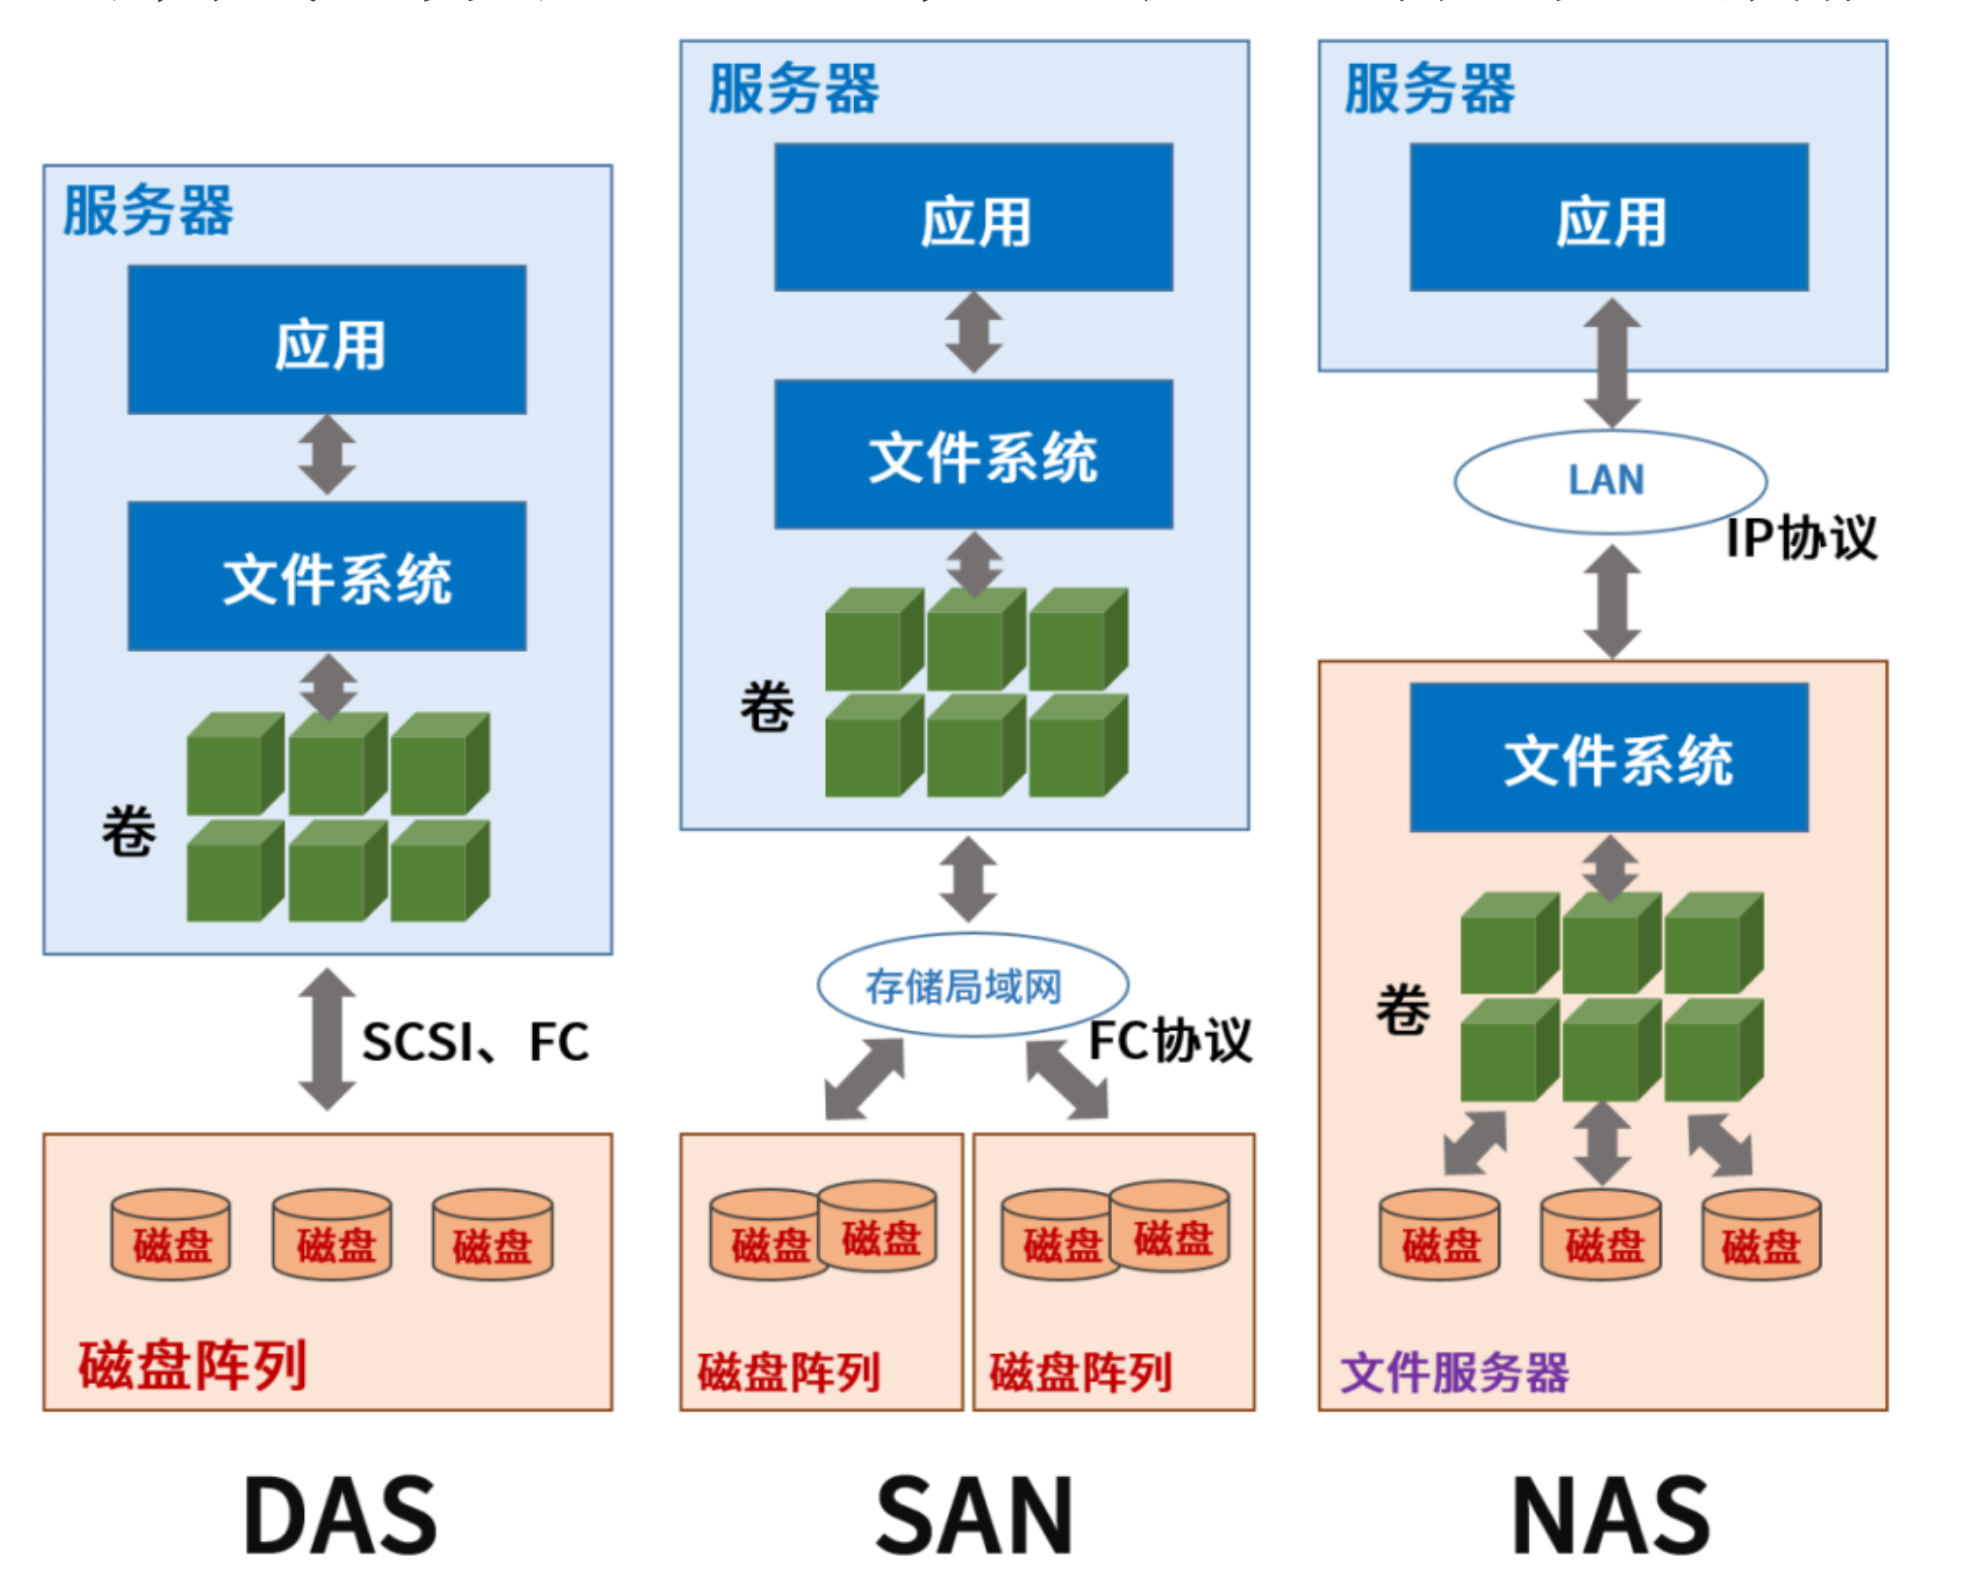 文件存储 Network-Attached Storage(NAS)
块存储 Direct-Attached Storage(DAS)和 Storage Area Networks(SAN)
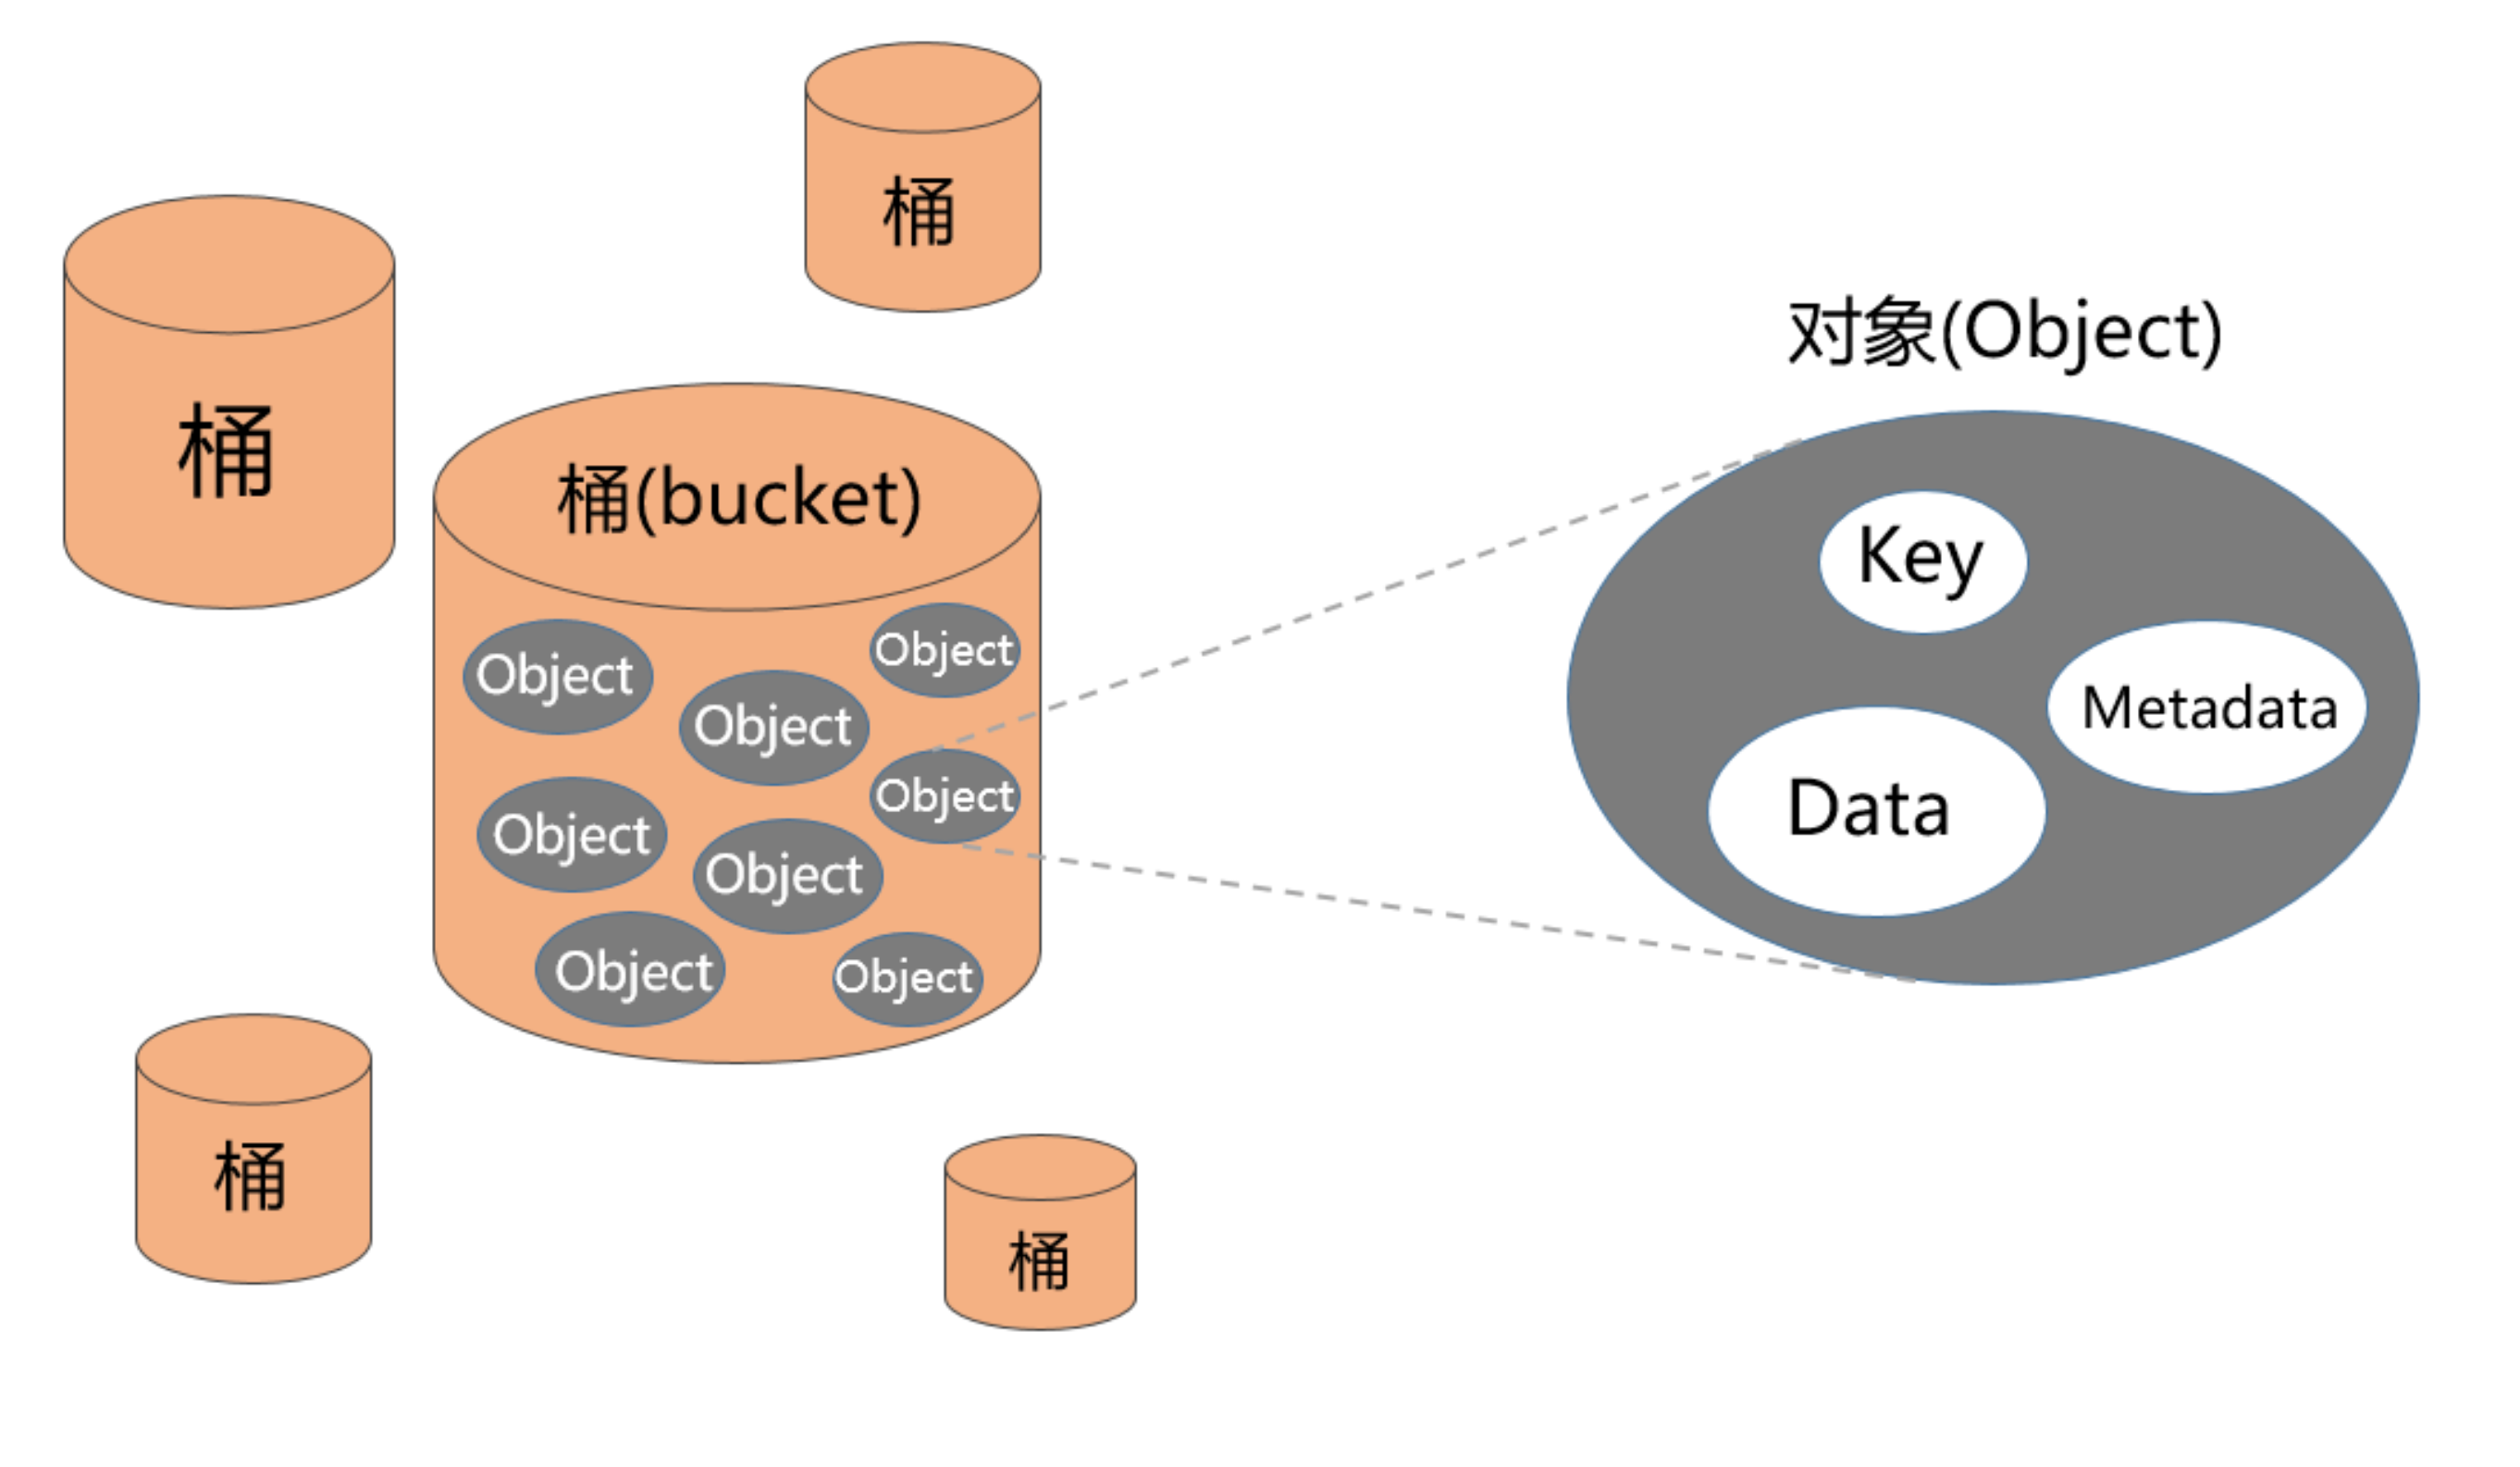
对象存储 Object-based Storage

块存储,操作对象是磁盘。存储协议是SCSI、iSCSI、FC。
以 SCSI 为例,主要接口命令有 Read/Write/Read Capacity/Inquiry 等等。
文件存储,操作对象是文件和文件夹。存储协议是 NFS、SAMBA(SMB)、POSIX等。
以 NFS(大家应该都用过“网上邻居”共享文件吧?就是那个)为例,文件相关的接口命令包括:READ/WRITE/CREATE/REMOVE/RENAME/LOOKUP/ACCESS 等等,文件夹相关的接口命令包括:MKDIR/RMDIR/READDIR 等等。
对象存储,主要操作对象是对象(Object)。存储协议是S3、Swift等。 在对象存储系统里,你不能直接打开/修改文件,只能先下载、修改,再上传文件
 组成
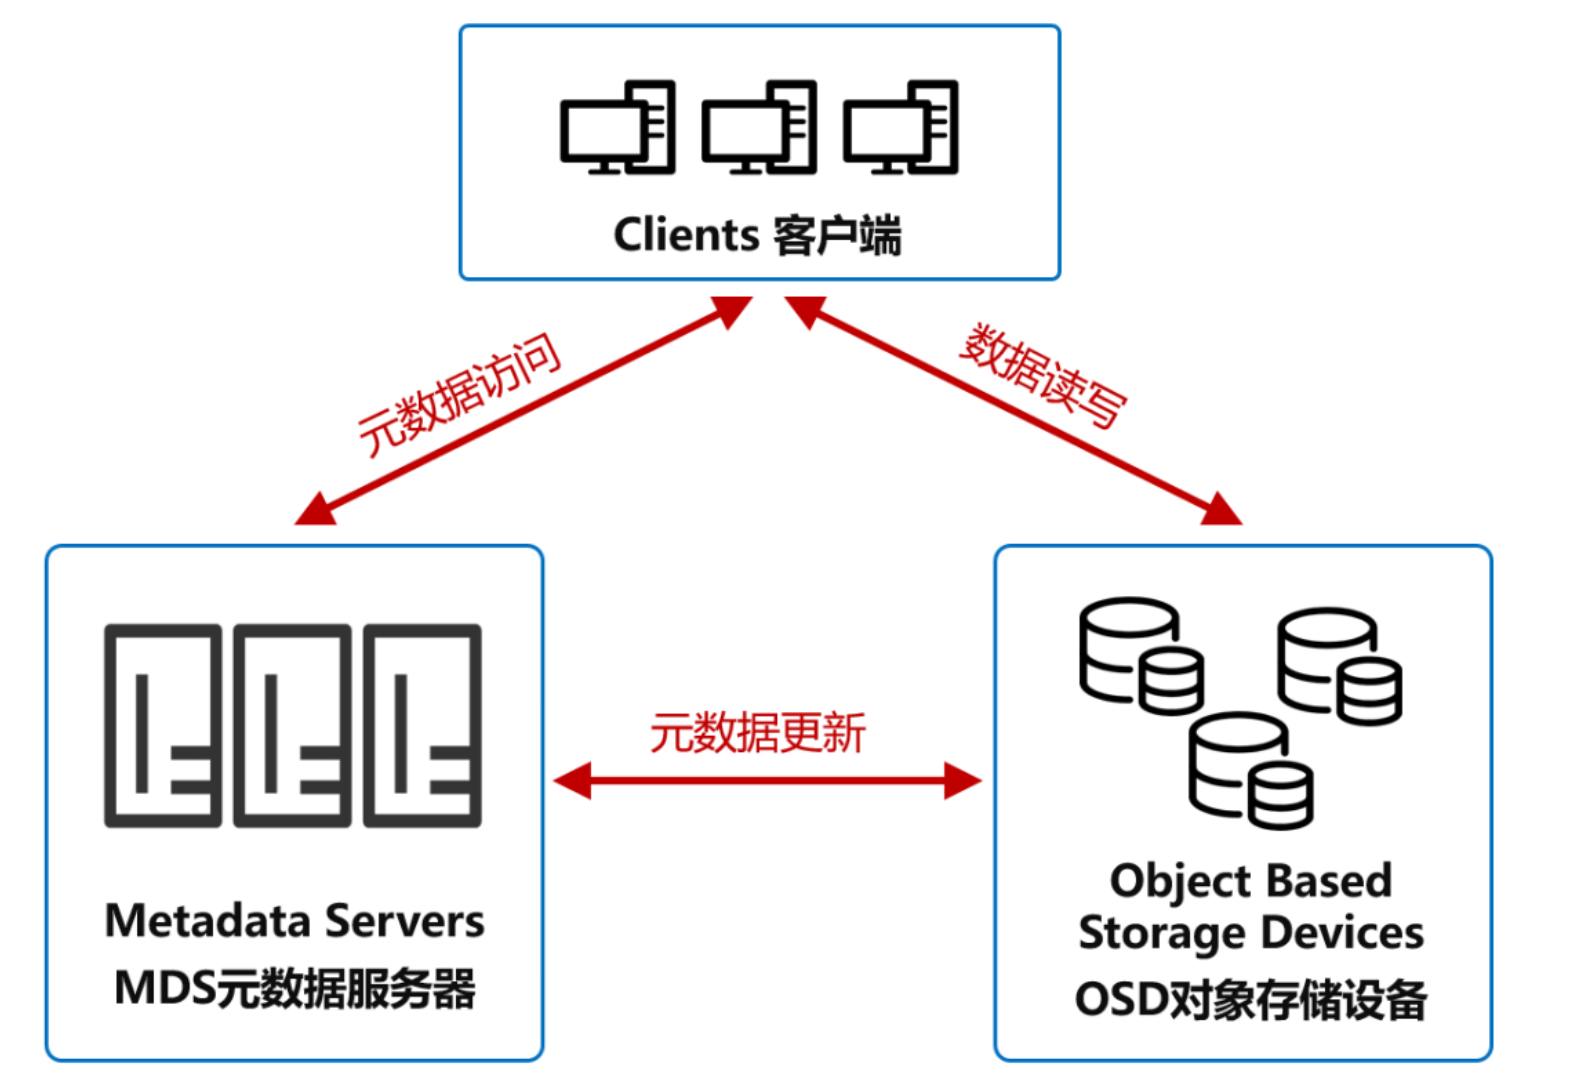
OSD 对象存储设备
这是对象存储的核心,具有自己的 CPU、内存、网络和磁盘系统。它的主要功能当然是存储数据。同时,它还会利用自己的算力,优化数据分布,并且支持数据预读取,提升磁盘性能。
MDS 元数据服务器
它控制 Client 和 OSD 的交互,还会管理着限额控制、目录和文件的创建与删除,以及访问控制权限。
Client 客户端
提供文件系统接口,方便外部访问。
根据上面的架构可以看出,对象存储系统可以是一个提供海量存储服务的分布式架构。
MinIO is a high-performance, S3 compatible object store, open sourced under GNU AGPLv3 license. https://github.com/minio/minio
…领域驱动设计(DDD)基础
限界上下文之间的映射关系
- 合作关系(Partnership):两个上下文紧密合作的关系,一荣俱荣,一损俱损。
- 共享内核(Shared Kernel):两个上下文依赖部分共享的模型。
- 客户方-供应方开发(Customer-Supplier Development):上下文之间有组织的上下游依赖。
- 遵奉者(Conformist):下游上下文只能盲目依赖上游上下文。
- 防腐层(Anticorruption Layer):一个上下文通过一些适配和转换与另一个上下文交互。
- 开放主机服务(Open Host Service):定义一种协议来让其他上下文来对本上下文进行访问。
- 发布语言(Published Language):通常与OHS一起使用,用于定义开放主机的协议。
- 大泥球(Big Ball of Mud):混杂在一起的上下文关系,边界不清晰。
- 另谋他路(SeparateWay):两个完全没有任何联系的上下文。
实体
当一个对象由其标识(而不是属性)区分时,这种对象称为实体(Entity)。
例:最简单的,公安系统的身份信息录入,对于人的模拟,即认为是实体,因为每个人是独一无二的,且其具有唯一标识(如公安系统分发的身份证号码)。
值对象
当一个对象用于对事务进行描述而没有唯一标识时,它被称作值对象(Value Object)。
例:比如颜色信息,我们只需要知道{“name”:“黑色”,”css”:“#000000”}这样的值信息就能够满足要求了,这避免了我们对标识追踪带来的系统复杂性。
值对象很重要,在习惯了使用数据库的数据建模后,很容易将所有对象看作实体。使用值对象,可以更好地做系统优化、精简设计。
它具有不变性、相等性和可替换性。
在实践中,需要保证值对象创建后就不能被修改,即不允许外部再修改其属性。在不同上下文集成时,会出现模型概念的公用,如商品模型会存在于电商的各个上下文中。在订单上下文中如果你只关注下单时商品信息快照,那么将商品对象视为值对象是很好的选择。
聚合根
Aggregate(聚合)是一组相关对象的集合,作为一个整体被外界访问,聚合根(Aggregate Root)是这个聚合的根节点。
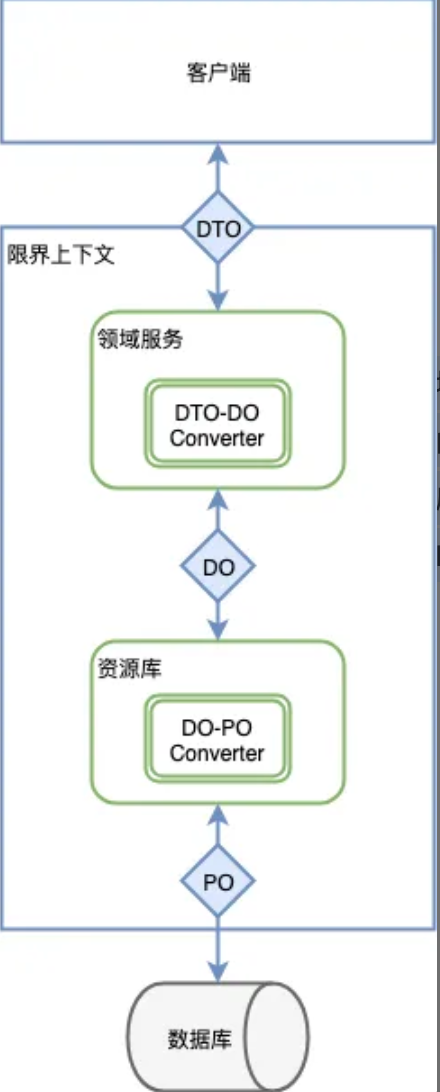
首先领域的开放服务通过信息传输对象(DTO)来完成与外界的数据交互;
在领域内部,我们通过领域对象(DO)作为领域内部的数据和行为载体;
在资源库内部,我们沿袭了原有的数据库持久化对象(PO)进行数据库资源的交互。
同时,DTO与DO的转换发生在领域服务内,DO与PO的转换发生在资源库内。
数据库与消息队列笔记
面试知识
数据库
索引: 事务 隔离级别 锁 https://www.notion.so/elonnzhang/23d21f3fbf218061963dee831cdecd91?source=copy_link
消息队列
通常来说,使用消息队列主要能为我们的系统带来下面三点好处:
- 异步处理
- 削峰/限流
- 降低系统耦合性
- 分布式事务、顺序保证和数据流处理。 可能会遇到的问题
- 消息丢失、重复消费
Kafka
发布-订阅模型 : 1 -> N

发布订阅模型(Pub-Sub) 使用主题(Topic) 作为消息通信载体,类似于广播模式;发布者发布一条消息,该消息通过主题传递给所有的订阅者,在一条消息广播之后才订阅的用户则是收不到该条消息的。
在发布 - 订阅模型中,如果只有一个订阅者,那它和队列模型就基本是一样的了。所以说,发布 - 订阅模型在功能层面上是可以兼容队列模型的。
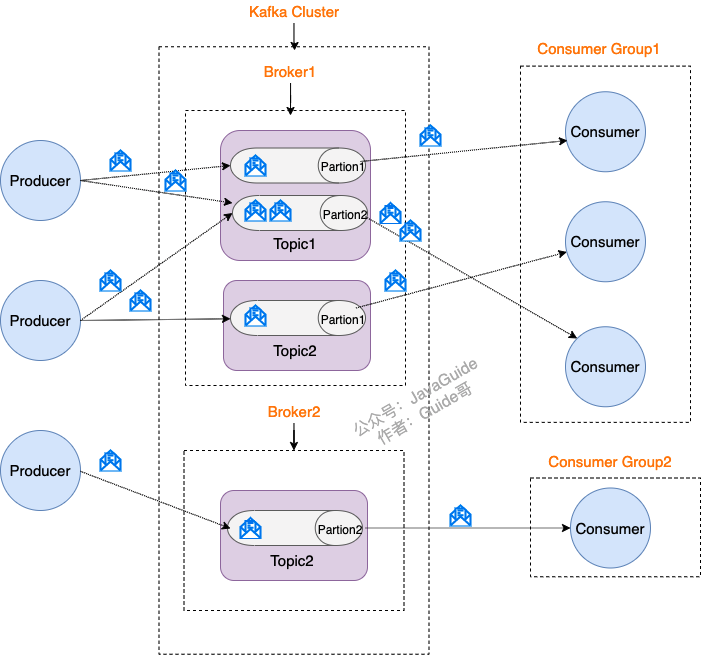 Kafka 比较重要的几个概念:
- Producer(生产者) : 产生消息的一方。
- Consumer(消费者) : 消费消息的一方。
- Broker(代理) : 可以看作是一个独立的 Kafka 实例。多个 Kafka Broker 组成一个 Kafka Cluster。
同时,你一定也注意到每个 Broker 中又包含了 Topic 以及 Partition 这两个重要的概念:
- Topic(主题) : Producer 将消息发送到特定的主题,Consumer 通过订阅特定的 Topic(主题) 来消费消息。
- Partition(分区) : Partition 属于 Topic 的一部分。一个 Topic 可以有多个 Partition ,并且同一 Topic 下的 Partition 可以分布在不同的 Broker 上,这也就表明一个 Topic 可以横跨多个 Broker 。
分区进一步理解
…Raft 共识算法笔记
分布式系统下的一致性问题
分布式系统有多个服务节点,给定一系列操作,在约定协议的保障下,使得它们对处理结果达成某种程度的协同。
分布式系统中的节点通信存在两种模型:
- 共享内存(Shared memory)
- 消息传递(Messages passing)。 基于消息传递通信模型的分布式系统,不可避免的会发生以下错误:进程可能会响应慢、被杀死或者重启,消息可能会延迟、丢失、重复;发生上面任意一种异常都会对分布式系统中各个节点对某一个值达成一致性产生问题。
一致性
- 强一致性
- 弱一致性
- 最终一致性
共识算法 共识算法(Consensus Algorithm)是分布式系统中用于在多个节点之间就某个值达成一致的算法,即使在存在节点故障、网络分区的情况下,也能确保系统状态的一致性。
共识算法解决的问题
共识算法解决的是分布式系统对某个提案(Proposal),大部分节点达成一致意见的过程。提案泛指多个事件发生的顺序、某个键对应的值…对于分布式系而言,各个节点通常都是相同的确定性状态机模型(又称为状态机复制问题,State-Machine Replication),从相同初始状态开始接收相同顺序的指令,则可以保证相同的结果状态。
这里共识算法需要解决两个基本问题:
- 如何提出一个待共识的提案(令牌传递、随机选取…)
- 如何让多个节点对提案达成共识(投票、规则验证…)
现实网络环境中存在各种各样的问题,在分布式环境下,共识算法还需要解决如通信问题(网络中断、分区)、节点故障、消息伪造…
CAP定理 CAP定理(CAP theorem),又被称作布鲁尔定理(Brewer’s theorem),它指出对于一个分布式计算系统来说,不可能同时满足以下三点,只能满足三项中的两项:
- C(一致性):任何事务都应该是原子的,所有副本上的状态都是事务成功提交后的结果,并保持强一致性。
- A(可用性):系统正常节点能在有限时间内完成对操作请求的应答。
- P(分区容错性):系统中的网络可能发生分区故障(成为多个子网、节点上线和下线),节点之间的通信无法保障,而网络故障不应该影响到系统正常服务。
结论:在分布式系统中 P 必须要保证,只能在 C 和 A 之间权衡:
- 保 C(强一致性)→ 可能牺牲可用性(如 Zookeeper)
- 保 A(高可用)→ 只能是最终一致性(如 Dynamo、Cassandra)
三类系统模型
- CA(一致性+可用性):包括完全严格的仲裁协议,例如2PC(两阶段提交)。
- CP(一致性+分区容错性): 包括多数仲裁协议,其中少数分区不可用,例如Paxos。
- AP(可用性+分区容错性): 包括执行最终一致性的协议,例如Gossip。
ACID ACID 即 Atomicity(原子性)、Consistency(一致性)、Isolation(隔离性)、Durability(持久性)四种特性的缩写,一般出现在分布式数据库等基于事务过程的系统中;ACID 原则描述了分布式数据库需要满足的一致性需求,同时允许付出可用性的代价。
- Atomicity: 每次事务是原子的,事务包含的所有操作要么全部成功,要么全部不执行。一旦有操作失败,则需要回退状态到执行事务之前;
- Consistency: 数据库的状态在事务执行前后的状态是一致的和完整的,无中间状态。即只能处于成功事务提交后的状态;
- Isolation: 各种事务可以并发执行,但彼此之间互相不影响。按照标准 SQL 规范,从弱到强可以分为未授权读取、授权读取、可重复读取和串行化四种隔离等级;
- Durability: 状态的改变是持久的,不会失效。一旦某个事务提交,则它造成的状态变更就是永久性的。
BASE原则 BASE即 Basic Availability(基本可用),Soft-state(弱状态),Eventual Consistency(最终一致性),为 eBay 技术专家 Dan Pritchett 提出的与ACID相对的一个原则,主要面向大型高可用分布式系统,主张牺牲掉对强一致性的追求,而实现最终一致性,来换取一定的可用性。
…pt-online-schema-change 执行流程
地址 https://github.com/percona/percona-toolkit/tree/3.x/bin 使用文档
详细执行流程如下:
- 相关环境参数检查
- 检查该表格是否存在
- show create table tbosc
- create table _tbosc_new
- alter table _tbosc_new
- 创建删除触发器 pt_osc_dbddl_tbosc_del (如果数据修改的时候,还没有拷贝过来,修改后再拷贝则是覆盖,正确;如果是已经拷贝过来,再修改,也是正确,这里同时会检查是否具有主键或者唯一索引,如果都没有,这一步会报错,提示The new table
dbosc._tbosc_newdoes not have a PRIMARY KEY or a unique index which is required for the DELETE trigger.) - 创建更新触发器 pt_osc_dbddl_tbosc_upd
- 创建插入触发器 pt_osc_dbddl_tbosc_ins
- 按块拷贝数据到新表,拷贝过程对数据行持有S锁
- analyze 新表
- rename 表名,RENAME TABLE
dbddl.tboscTOdbddl._tbosc_old,dbddl._tbosc_newTOdbddl.tbosc - 删除旧表
- 删除新表上的删除、更新、插入 触发器
如果有表存在会新建表
failed to find a unique new table name after 10 attemps.  the following tables exist which may be left over from previous failed runs of the tool:
  `test_db`.`_big_table_new`
  `test_db`.`__big_table_new`
  `test_db`.`___big_table_new`
  `test_db`.`____big_table_new`
  `test_db`.`_____big_table_new`
  `test_db`.`______big_table_new`
  `test_db`.`_______big_table_new`
  `test_db`.`________big_table_new`
  `test_db`.`_________big_table_new`
  `test_db`.`__________big_table_new`
examine these tables and drop some or all of them if they are no longer need, then re-run the tool.
https://deepwiki.com/percona/percona-toolkit/2.1-pt-online-schema-change
…使用 Jekyll 搭建 GitHub Pages
jekyll (Theme) + Github Page
step0: install brew
step1: install ruby
why not
brew install ruby? macOS has a default ruby ❯ ruby -v ruby 2.6.10p210 (2022-04-12 revision 67958) [universal.arm64e-darwin25]
Install chruby and ruby-install
brew install chruby ruby-install
ruby-install ruby 3.4.1
change default ruby to new download ruby
echo "source $(brew --prefix)/opt/chruby/share/chruby/chruby.sh" >> ~/.zshrc echo "source $(brew --prefix)/opt/chruby/share/chruby/auto.sh" >> ~/.zshrc echo echo "chruby ruby-3.4.1" >> ~/.zshrc # run 'chruby' to see actual version
test version
…