数据库与消息队列笔记
面试知识
数据库
索引: 事务 隔离级别 锁 https://www.notion.so/elonnzhang/23d21f3fbf218061963dee831cdecd91?source=copy_link
消息队列
通常来说,使用消息队列主要能为我们的系统带来下面三点好处:
- 异步处理
- 削峰/限流
- 降低系统耦合性
- 分布式事务、顺序保证和数据流处理。 可能会遇到的问题
- 消息丢失、重复消费
Kafka
发布-订阅模型 : 1 -> N

发布订阅模型(Pub-Sub) 使用主题(Topic) 作为消息通信载体,类似于广播模式;发布者发布一条消息,该消息通过主题传递给所有的订阅者,在一条消息广播之后才订阅的用户则是收不到该条消息的。
在发布 - 订阅模型中,如果只有一个订阅者,那它和队列模型就基本是一样的了。所以说,发布 - 订阅模型在功能层面上是可以兼容队列模型的。
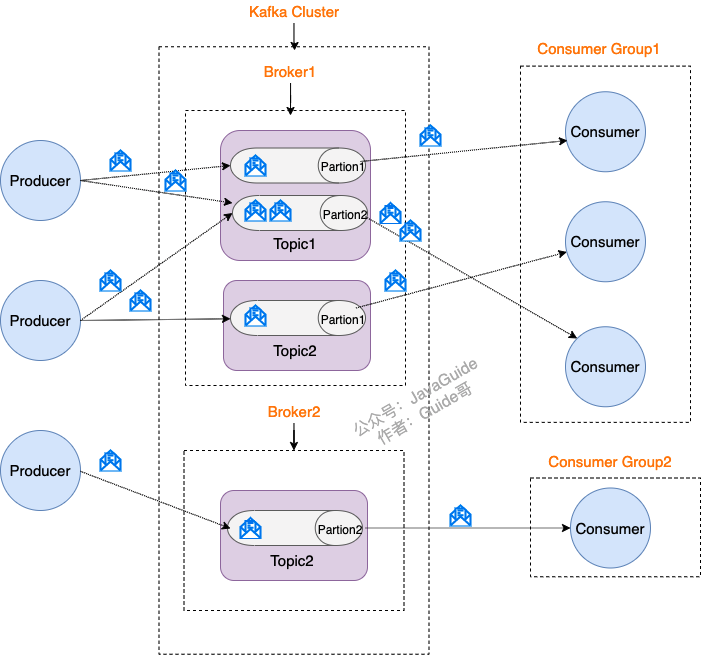 Kafka 比较重要的几个概念:
- Producer(生产者) : 产生消息的一方。
- Consumer(消费者) : 消费消息的一方。
- Broker(代理) : 可以看作是一个独立的 Kafka 实例。多个 Kafka Broker 组成一个 Kafka Cluster。
同时,你一定也注意到每个 Broker 中又包含了 Topic 以及 Partition 这两个重要的概念:
- Topic(主题) : Producer 将消息发送到特定的主题,Consumer 通过订阅特定的 Topic(主题) 来消费消息。
- Partition(分区) : Partition 属于 Topic 的一部分。一个 Topic 可以有多个 Partition ,并且同一 Topic 下的 Partition 可以分布在不同的 Broker 上,这也就表明一个 Topic 可以横跨多个 Broker 。
分区进一步理解
- 代理(Broker: 实例节点
- 主题(Topic):Kafka 的消息类别,可以类比数据库的“表”。(topic可以跨 brocker,类似于分片表 shard)
- 分区(Partition):是 Topic 的物理存储单位,每个 Topic 可以有多个分区。
Topic: order-events ├── Partition 0: msg0, msg1, msg2 … ├── Partition 1: msg3, msg4, msg5 … └── Partition 2: msg6, msg7, msg8 …
为什么要分区?
- 扩展性(Scalability)
- 多个分区可以分布在不同的 Broker 上,形成集群,突破单机存储和吞吐瓶颈。
- 并行性(Parallelism)
- 每个分区可以被不同的消费者实例并行消费,提升处理速度。
- 高可用(HA)
- 分区可以配置副本(Replica),某个 Broker 挂了,副本仍然能提供服务。
生产者与分区的关系 生产者可以指定分区
消费者与分区的关系
- Kafka 的消费者组(Consumer Group)是以分区为单位分配消息的:
- 一个分区只能同时被一个消费者实例消费。
- 消费者实例数 <= 分区数,才能最大化并行。 分区与消息顺序
- Kafka 只保证分区内的消息顺序。
- 不同分区之间消息是乱序的。
分区数的设计
分区数越多:
- 并行度更高,吞吐量更大
- 但元数据更多,管理复杂度更高
分区数一旦确定,后续增加可能导致数据重分布(成本高)
经验值:
- 根据 峰值吞吐量 / 单分区最大吞吐量 来估算分区数。
- 分区数至少要大于消费者实例数,否则并行性浪费。
副本
Kafka 为分区(Partition)引入了多副本(Replica)机制。分区(Partition)中的多个副本之间会有一个叫做 leader ,其他副本称为 follower。我们发送的消息会被发送到 leader 副本,然后 follower 副本才能从 leader 副本中拉取消息进行同步。
生产者和消费者只与 leader 副本交互。你可以理解为其他副本只是 leader 副本的拷贝,它们的存在只是为了保证消息存储的安全性。当 leader 副本发生故障时会从 follower 中选举出一个 leader,但是 follower 中如果有和 leader 同步程度达不到要求的参加不了 leader 的竞选。
Partition 0 (Leader: Broker1, Follower: Broker2, Broker3)
Kafka 的多分区(Partition)以及多副本(Replica)机制有什么好处呢?
- Kafka 通过给特定 Topic 指定多个 Partition, 而各个 Partition 可以分布在不同的 Broker 上, 这样便能提供比较好的并发能力(负载均衡)。
- Partition 可以指定对应的 Replica 数, 这也极大地提高了消息存储的安全性, 提高了容灾能力,不过也相应的增加了所需要的存储空间。
kafka中的zookeeper
ZooKeeper 主要为 Kafka 提供元数据的管理的功能。
- Broker 注册:在 Zookeeper 上会有一个专门用来进行 Broker 服务器列表记录的节点。每个 Broker 在启动时,都会到 Zookeeper 上进行注册,即到
/brokers/ids下创建属于自己的节点。每个 Broker 就会将自己的 IP 地址和端口等信息记录到该节点中去 - Topic 注册:在 Kafka 中,同一个Topic 的消息会被分成多个分区并将其分布在多个 Broker 上,这些分区信息及与 Broker 的对应关系也都是由 Zookeeper 在维护。比如我创建了一个名字为 my-topic 的主题并且它有两个分区,对应到 zookeeper 中会创建这些文件夹:
/brokers/topics/my-topic/Partitions/0、/brokers/topics/my-topic/Partitions/1 - 负载均衡:上面也说过了 Kafka 通过给特定 Topic 指定多个 Partition, 而各个 Partition 可以分布在不同的 Broker 上, 这样便能提供比较好的并发能力。 对于同一个 Topic 的不同 Partition,Kafka 会尽力将这些 Partition 分布到不同的 Broker 服务器上。当生产者产生消息后也会尽量投递到不同 Broker 的 Partition 里面。当 Consumer 消费的时候,Zookeeper 可以根据当前的 Partition 数量以及 Consumer 数量来实现动态负载均衡。
Kafka 2.8 之后 引入了基于 Raft 协议的 KRaft 模式,不再依赖 Zookeeper